从 Volcano 到 Morsel:DuckDB 并行执行器的设计原理
Author: 杨泽(勉仁)
本文结合 Morsel-Driven Parallelism 论文(Leis 等,SIGMOD 2014,源自 HyPer),拆解 DuckDB 并行执行器的设计:它的并行模型出自何处、为何长成今天这个形态。
插播一个广告:PolarDB PostgreSQL 的 分析引擎 基于 DuckDB,同时提供了列存索引(向量化引擎)和云原生 DuckDB 列存表。本文拆解的这套并行执行器,正是这些特性背后的分析引擎底座。
0 结论
一条分析查询要在几十上百个核上跑起来,执行器必须回答两个问题:并行度定为多少,数据怎么分给各个线程。DuckDB 与传统关系型引擎在这两个问题上给出了不同的答案。
DuckDB 的并行执行器是 Morsel-Driven Parallelism(Leis 等,SIGMOD 2014,源自 HyPer)的工程实现,而不是 Volcano + Exchange 的并行化改造。 两者的结构差异体现在三个方面(右两列给出 DuckDB 的具体代码与运行行为):
| 判据 | Volcano + Exchange | DuckDB |
|---|---|---|
| 并行度是否写入执行计划 | 是。优化器在编译期确定 DOP 并编码进计划 | 否。物理计划中不含线程数信息,MaxThreads() 在运行期计算 |
| 数据如何分配给线程 | 编译期静态分区,线程与分片绑定 | 运行期动态领取,任务从全局游标取下一个 row group |
| 任务能否更换执行线程 | 不能。一个线程处理一个分片直到结束 | 能。执行片段结束后携带全部状态回队列,可由另一个 worker 续跑 |
模型形态由四个部分组成:
- pipeline 事件 DAG——拓扑在编译期确定,负责表达”谁必须先于谁”;
- 全局无锁任务队列——执行期动态分配,负责表达”此刻谁来干”;
- row group 分片——morsel 的物理实体,负责表达”一次干多少”;
- thread-local 中间状态——算子内部无锁累积,负责表达”结果先放哪”。
DuckDB 继承了论文执行模型的核心机制,但未实现其中的 NUMA 感知部分。这一裁剪与它”进程内嵌入式单机分析引擎”的定位一致,第 5 节给出与 HyPer 的逐项对照。
本篇的展开顺序是:
- 第 1 节 硬件:并行执行的约束条件发生了什么变化;
- 第 2 节 plan-driven:为何是 1990 年代硬件条件下的最优解;
- 第 3 节 失配:条件变化后,Exchange 在哪些场景不再适配;
- 第 4 节 morsel-driven:用什么机制逐条回应这些场景;
- 第 5 节 DuckDB:借鉴了论文调度与领取的核心机制、三层粒度嵌套、任务与分片解耦,裁掉了 per-socket 队列与整套 NUMA 感知(四个机制只剩线程绑核且仅限 glibc 平台)。
1 硬件:并行执行模型的约束条件
执行模型的每一次迁移,对应的都是硬件参数表上的变化。Morsel-Driven 所回应的,是 1995 年到论文发表的 2014 年这二十年里的三条曲线。这三条曲线在 2014 年之后没有反转,只是继续外推,因此论文的设计前提到今仍然成立。
1.1 三条曲线
核数量级上升。 1995 年一台高端 SMP 服务器有 4—8 个 CPU;2014 年论文的测试机是 4 路 × 8 核,32 物理核 / 64 逻辑核;今天一台云主机远超这个数字。面向云厂商定制的 AMD EPYC(Zen 5)单路即可达 128 物理核 / 256 逻辑核,双路为 256 物理核 / 512 逻辑核;这类定制 SKU 的核密度比零售旗舰更高,而 2022 年的 EPYC 9654(Zen 4,单路 96 核 192 线程)在零售市场已属顶配。并行度从个位数进入三位数,这是后续所有变化的前提。
内存容量上升、单价下降。 1TB 内存从特殊配置变为常规云主机档位,分析型负载的瓶颈由 I/O 转移到 CPU 与内存带宽。
内存墙形成。 CPU 频率与 IPC 的改善速度远高于 DRAM 延迟,一次内存访问的等待从几十个周期变为数百个周期。cache 命中率成为主导变量,”数据离计算多远”从二阶因素变为一阶因素。
三条曲线合并的结果:性能的决定因素由磁盘带宽转移到内存局部性与核间协调效率。而 Volcano/Exchange 模型对这两者都不作表达。
1.2 NUMA 的由来:内存控制器进入 CPU die
论文标题中的 NUMA-Aware 不是一个软件概念,而是封装形态变化的直接结果。
早期是 FSB 架构:内存控制器位于主板北桥,所有 CPU 经同一条前端总线访问同一个控制器。这是真正的 UMA——任何 CPU 访问任何地址的延迟一致,代价是总线成为共享瓶颈,CPU 数量一多即出现争用。
Intel 自 Nehalem、AMD 自 Opteron 起,内存控制器(iMC)被集成进 CPU die。带宽问题由此解决:每个 socket 拥有独立的 iMC、独立的内存通道与直连的 DIMM 插槽,socket 越多总带宽越大。代价是内存自此具有归属。
进入封装的只是控制器,内存条仍插在主板插槽上;变的是走线归属——DIMM 插槽被分组,每组只直连某一个 socket。因此所谓”本地内存”指的是插在本 socket 那组通道上的内存条,对端 socket 要取这些数据,请求必须先送到本 socket 的 iMC,再经 UPI 回传。以双路 EPYC Genoa 为例,每 socket 12 个 DDR5 通道,numactl --hardware 里 node 0 / node 1 各自的 size 就是这个分组结果。
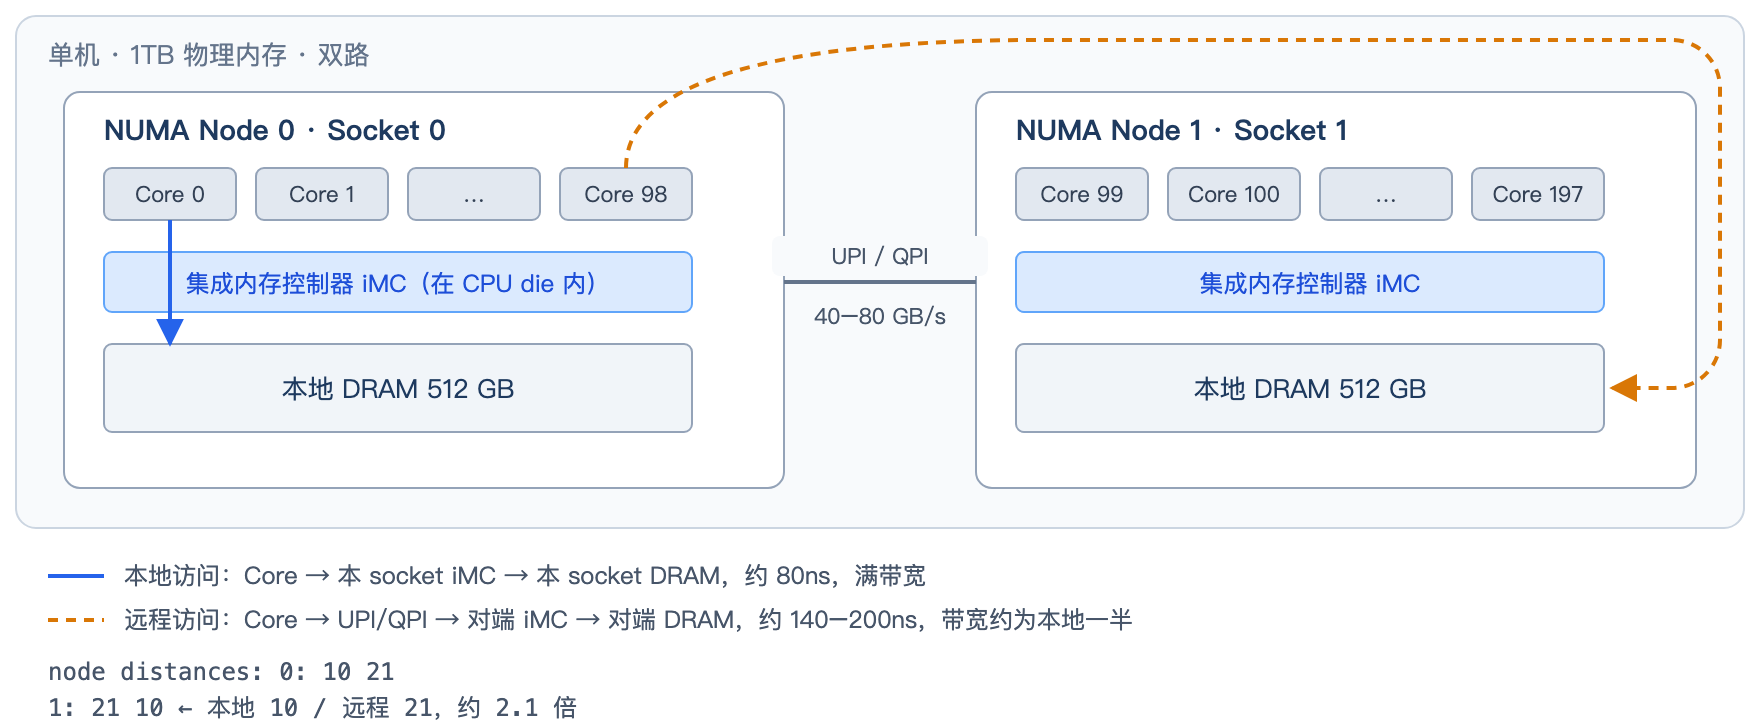
图 1 内存控制器进入 CPU die 之后:同一台机器上的两种内存访问路径
于是同一台机器上出现两种内存访问路径:
| 路径 | 延迟量级 | 带宽 |
|---|---|---|
| 本地:Core → 本 socket iMC → 本 socket DRAM | ~80ns | 满带宽 |
| 远程:Core → UPI/QPI → 对端 iMC → 对端 DRAM | ~140–200ns | 本地的 1/2 ~ 1/3 |
这两个数字由操作系统直接给出:
$ numactl --hardware
available: 2 nodes (0-1)
node 0 cpus: 0 1 2 ... 98
node 0 size: 512000 MB
node 1 cpus: 99 100 ... 197
node 1 size: 512000 MB
node distances:
node   0   1
  0:  10  21      ← 本地 10,远程 21,约 2.1 倍
  1:  21  10
node distances 矩阵即 NUMA 的全部含义:同一个 malloc 返回的指针,被不同的核访问,延迟相差一倍以上。对纯内存的分析查询而言,这意味着扫描同样多的数据可能产生成倍的耗时差,而执行计划中没有任何字段能表达这一差异。
1.3 拓扑的进一步细分:chiplet 与 NPS
NUMA 层级并非只有两层,而且在持续增加。现代 AMD EPYC 采用 chiplet 架构:一个封装内含多个计算 die(CCD)与一个 I/O die(IOD)。全部内存控制器都在 IOD 上——Genoa 的 12 个 DDR5 通道对应 12 个控制器,CCD 自身不带内存控制器,任何取数都要经 Infinity Fabric 走到 IOD:
┌───────────────────────────────────────────┐
│  AMD EPYC 封装(1 Socket / 96 核)         │
│  [CCD 0][CCD 1][CCD 2][CCD 3]             │
│  [CCD 4][CCD 5][CCD 6][CCD 7]             │
│           [ IOD(含 iMC)]  ← 12 通道 DDR5  │
└───────────────────────────────────────────┘
控制器集中到 IOD,是为了消除 socket 内部的不均匀。Zen 1(Naples)把内存控制器分散在四个计算 die 上,每 die 两通道,一个 socket 必然呈现为四个 NUMA node,且 die 间差异无法消除;Zen 2 起改为集中式,所有 CCD 取数都走同一颗 IOD,socket 内的差异大幅收窄,因此可以对外表现为单个 node。
但单个 node 是一种简化。IOD 内部按四个象限布线,每象限挂 3 个 DDR5 通道,每个 CCD 访问本象限的通道延迟最低。默认配置把地址交织在全部 12 个通道上,将这一距离差异平均掉:每次访问的延迟都是均值,均匀,但都不是最优。
BIOS 中的 NPS(Nodes Per Socket)提供反向选择——缩小地址交织范围,把一个 socket 拆成多个 NUMA node,使就近的通道成为 node 内的本地内存:
| NPS | 地址交织范围 | socket 暴露的 node 数 |
|---|---|---|
| 1 | 全部 12 通道 | 1 |
| 2 | 每半边 6 通道 | 2 |
| 4 | 每象限 3 通道 | 4 |
Intel 侧的对应机制是 SNC(Sub-NUMA Clustering),把一颗多 tile 的 die 切成 2 或 4 个域,思路一致。
NPS 越高,单个 node 越小、局部性越强、延迟越低,同时对软件的拓扑感知能力要求越高——这是论文标题中 NUMA-aware 的由来。DuckDB 面对的是另一类运行环境:笔记本、单路云主机、进程内嵌入式部署,绝大多数只有一个 NUMA node,这层拓扑不出现在它的执行路径上。它的工程投入因此集中在与拓扑无关的部分——morsel 核心机制、三层粒度对齐、任务与分片解耦,这些机制在单 node 与多 node 上同样成立:一套代码、零拓扑配置,从笔记本到多路服务器共用同一条执行路径。第 5 节给出与论文的逐项对照。
1.4 first-touch:内存归属由第一次写入决定
对数据库实现影响最大的机制是:内存落在哪个 node 上不由 malloc 决定,而由第一次写入决定。Linux 默认采用 first-touch policy:
char *buf = malloc(1 GB);   // ① 仅分配虚拟地址,页表项标记 not-present,
                            //    此时尚未分配任何物理页
memset(buf, 0, 1 GB);       // ② 逐页触发 page fault,OS 在【触发 fault 的线程
                            //    所在 NUMA node】上分配物理页
由此得到两条推论。
其一,内存的物理归属由线程的调度位置决定。 若上述 memset 由绑定在 Socket 0 的线程执行,1GB 全部落在 Node 0;此后 Socket 1 上的线程访问该缓冲区,一律是远程访问。数据布局成为线程行为的副产品。
其二,线程绑核本身即构成一半的 NUMA 内存策略。 线程固定在某个 socket 后,它 first-touch 产生的全部内存——thread-local 哈希表、排序缓冲、聚合状态——自动落在本地 DRAM,无需调用 numa_alloc_onnode。
这解释了 HyPer 为何几乎不使用显式 NUMA 分配 API:
| 机制 | HyPer 的做法 |
|---|---|
| 线程位置 | worker 线程经 pthread_setaffinity_np 永久绑核,插槽归属静态已知 |
| 数据放置 | 依赖 first-touch,线程首次写入即决定页归属 |
| morsel 分发 | dispatcher 优先将 morsel 发给数据所在 node 上的线程 |
| 中间结果 | 每线程写入自己的 thread-local buffer,天然本地 |
论文中 “a thread operates on NUMA-local input and writes results to NUMA-local storage” 的实现路径是绑核、first-touch、亲和分发三者配合。第 5 节将看到 DuckDB 实现了其中第一项。
1.5 小结
第 1 节的结论可以压缩为一句:内存控制器进入 die,内存因此具有归属;核数进入三位数,静态分配不再够用;内存墙形成,局部性由优化项变为主要矛盾。
Volcano/Exchange 模型的词汇表中既没有”内存位于哪个 node”,也没有”运行期调整并行度”。这两项在它成型的年代并不需要。
2 plan-driven:1990 年代硬件条件下的最优解
2.1 起点:Volcano 迭代器与 Exchange 算子
Volcano 模型的执行器是一棵算子树,每个算子只暴露 next(),由树根逐层向下拉取:
Aggregate.next() → Filter.next() → TableScan.next()
算子之间完全解耦、组合性很好,这是它长期占据主流的原因。代价是每行数据都要穿过一串虚函数调用,指令 cache 与分支预测均不友好;该问题后来由向量化(一次传递 2048 行而非 1 行)解决,DuckDB 同样采用这条路径。
与并行直接相关的是 Exchange 算子。它的设计目标是:让算子树保持对并行无感知,把并行度、数据重分布、线程间通信全部封装进一类特殊算子。并行计划因此呈现为若干份相同子树加汇聚节点:
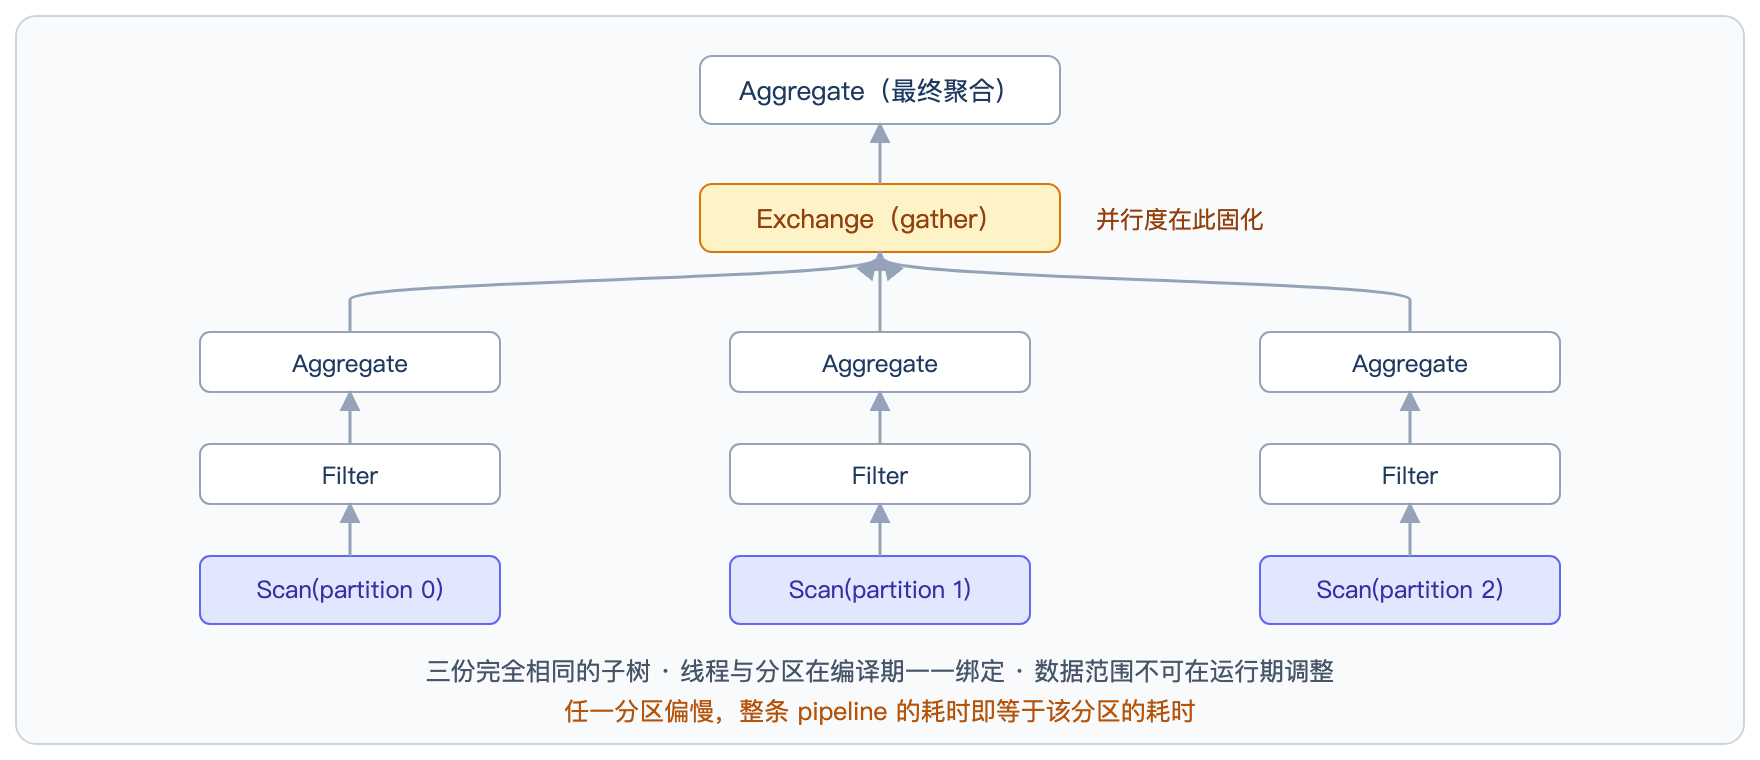
图 2 Volcano + Exchange 的并行计划:并行结构在编译期固化
其核心特征是:优化器在编译期确定线程数量与每个线程负责的数据范围,计划生成后并行结构即固化。这就是 plan-driven parallelism。它最大的工程收益是并行逻辑与算子逻辑彻底解耦,算子实现者无需处理多线程。
2.2 1990 年代的三条技术路线
并行执行在当年存在三条不同路线:
| 路线 | 架构 | 代表系统 | 并行手段 |
|---|---|---|---|
| 单机 SMP 并行 | 一台机器多 CPU / 多磁盘 | Oracle PQO、SQL Server 7.0+、Sybase IQ、Tandem NonStop SQL | 查询内并行:并行扫描、并行连接、流水线并行 |
| shared-nothing MPP | 无共享,装载时静态分区到节点 | Teradata、Gamma(学术)、DB2 Parallel Edition、Informix XPS | 节点级数据分区 + Exchange 网络重分布 |
| shared-disk | 共享存储,各节点独立缓冲池 | Oracle OPS / RAC、DB2 data sharing | 并行查询 + 缓存一致性协议 |
其中 Gamma(DeWitt、Schneider 等,Wisconsin,1990)是学术界的主要源头。它将数据重分布形式化为三种算子:round-robin(均匀打散)、hash partition(按键哈希重分布,即今日 Spark Shuffle 与 Trino 的祖先形态)、broadcast(广播小表)。
Volcano 论文(Graefe 等,1994)在此基础上把三种重分布统一抽象为 Exchange 算子,使并行成为计划树中的一类普通节点。Exchange 模型因此可以看作对并行数据库十年实践的标准化封装。
系统谱系大致如下:
Gamma(学术源头)
  ├─→ Informix XPS
  ├─→ DB2 Parallel Edition / MPP
  └─→ Greenplum(2003,Postgres 血统,2000 年代 MPP 复兴的代表)

Teradata(独立源头,80 年代中期即商用)
Oracle(shared-disk 路线,自成一派)
2.3 Oracle:编译期决策的完整样本
Oracle 的产品线是”把事情在编译期算准”这一思路的完整样本:
| 时间 | 产品 / 特性 | 架构要点 |
|---|---|---|
| 1993 | Parallel Query Option(PQO),Oracle 7 | 当时最完整的商用并行查询实现:表扫描按 extent / 分区切成 pieces,多个 PX 进程并行扫描,经 table queue(生产者-消费者队列)交换数据,与 Volcano Exchange 同源 |
| 1997 | Oracle Parallel Server(OPS),Oracle 8 | shared-disk 集群雏形,缓存一致性较弱,主要用于容灾 |
| 2001 | RAC,Oracle 9i | shared-disk + Cache Fusion(节点间经高速互联直传缓存块),可用的共享存储集群 |
| 2008 | Exadata V1 | 一体机形态:数据库服务器 + 智能存储服务器(Smart Scan 将谓词下推至存储层),上层仍是 shared-disk |
三个细节是 plan-driven 的典型特征:
- 静态 DOP:并行度由
PARALLELhint、表级DEGREE属性与统计信息在编译期确定,EXPLAIN PLAN中可见 Q00 / Q01 这样的并行查询块,并行结构是计划的组成部分; - 交换算子:table queue 承担 producer-consumer 数据交换;
- 进程模型:每个并行 worker 是独立 OS 进程(PX 进程)而非线程。当年进程创建与切换开销较大,因此合理的工程选择是”一个进程处理一大块数据直到结束”,而非”处理十万行后重新排队”。
Exadata 代表对同一硬件变化的另一层回应。2008 年硬件已进入 many-core + NUMA 时代,Oracle 把突破口放在存储侧:将计算下推到数据附近(storage cell offload、Hybrid Columnar Compression、storage index),在数据搬运的源头消掉 I/O 瓶颈;执行侧继续 plan-driven,承担节点内并行的全部职责。改执行模型与改系统形态,是对同一组硬件曲线的两种并行答案。
把算力沉到存储层这条路线,同一时期有多家厂商并行探索。Netezza 起步更早(2003 起,TwinFin 时代成熟,2010 年被 IBM 收购):每块 S-Blade 自带 FPGA + CPU + 磁盘,数据出盘后先在 FPGA 上完成过滤与投影。Exadata 取了另一种形态:不做 per-node 数据分片,上层保留 shared-disk RAC,存储下推与 Oracle 全栈能力共存——两者分别是 shared-nothing 与 shared-disk 路线上的不同取舍。
按时间线归并:
80s-90s   shared-nothing MPP(Teradata / DB2 PE / Informix)+ shared-disk(Oracle)
          → plan-driven、静态 DOP、进程模型
2003-2008 数仓一体机(Netezza → Exadata → Greenplum DCA)
          → 思路是把计算推向数据,在存储层消掉 I/O 瓶颈
2014      Morsel 论文:在单机 many-core 场景下重解并行度问题
          → HyPer / DuckDB 一系:线程模型、动态任务、无静态 DOP
Morsel 解决的是第三阶段的问题。1990 年代的集群数据库尚未遇到该问题,它们面对的是”数据应放在哪个节点”,而不是”该给这条查询几个线程”。
2.4 成立条件:硬件、理论、产品
plan-driven 不是等待被替换的过渡形态:它在 1990 年代的硬件条件下是最优解,此后几十年承载着主流商业数据库的并行执行。其合理性由三类条件共同支撑——硬件使粗粒度静态划分在当年协调开销最小、访问模式最可预测;理论使并行既有通用算子表达、又有编译期代价估算;产品架构使这一设计沉淀为存量投入与可预测性承诺,至今难以被替换。
硬件与负载(主要因素)
核数少,静态分配足够。 1990 年代 Oracle 运行在几路到几十路 SMP 上,PARALLEL(8) 即 8 个进程,DOP 由 DBA 或优化器给定,估偏的影响有限——总核数有限,划分方式的空间很小。morsel 所解决的”上百核弹性分配”在 32 核以下基本不构成问题。
瓶颈在磁盘而非 CPU。 当年查询慢的原因是扫盘慢,并行的目标是打满磁盘带宽而非 CPU。达成该目标最有效的方式是把表按 range 切成若干大块、每个进程顺序扫描一块:粒度大、划分静态、协调开销接近于零。反之,”每十万行重新排队”的细粒度协调在 I/O-bound 负载下收益有限,调度开销换来的 CPU 均衡收益接近于零。
线程成本高,无锁队列尚不可用。 当年 OS 线程库仍不成熟(Linux 尚无 NPTL,Solaris LWP 亦有成本),Oracle 采用进程模型:fork 一个 PX 进程开销可观,进程间交换数据需经共享内存加锁。在这一成本结构下,”任务粒度细 + 频繁重新入队”不具备可行性。morsel 模型的前提是线程廉价、无锁 MPMC 队列可用,这两项在 2010 年前后才在工业界普及。
shared-disk 的缓存一致性成本高。 OPS 乃至 RAC 早期,跨节点传输缓存块的开销较大。一致性成本高意味着”数据最好由一个进程连续读完”,以减少 ping-pong;而运行期动态调度会让”谁在读哪些块”不可预测,加剧跨节点流量。静态 range 划分带来可预测的访问模式。
理论(次要因素:当年的并行化问题已有通用答案)
1994 年学界刚给出并行化任意算子的通用解法——插入一对 exchange 即可,这是当时唯一被验证的通用并行算子理论,业界没有动机另立范式。morsel 所需的组件(per-socket 无锁队列、work stealing、弹性并行度)在当年既无需求场景,也缺少成熟的工程积木。同期 Graefe 1993、DeWitt 1990 一批工作使优化器具备估算并行计划代价的能力;既然编译期算得出,就没有理由推迟到运行期。
产品架构(存量投入与可预测性承诺)
Oracle 的核心是 CBO,并行度是代价模型中的一个变量:DOP 取 8 还是 16,优化器需要用它估算代价并比较计划。改为运行期决定,意味着代价模型中不再有这个变量,整套优化器理论需要重写——这是产品架构问题而非单点技术问题。另一方面,可预测性本身是卖点:Resource Manager 管理资源组、hint 固定并行度、计划稳定可复现。企业运维需要的是”这条 SQL 会用几个进程”这一确定答案。
汇总:
| 因素 | 表现 | 性质 |
|---|---|---|
| 核数少(≤64) | 静态 DOP 的误差影响有限 | 硬件 |
| I/O-bound | 粗粒度静态划分收益最大 | 硬件 / 负载 |
| 线程成本高、无锁队列不可用 | 细粒度调度不具可行性 | 硬件 + 系统软件 |
| 缓存一致性成本高(shared-disk) | 静态划分带来可预测访问模式 | 硬件 |
| Volcano 是唯一成熟理论 | 无动机另立范式 | 算法 |
| 代价模型为架构存量、可预测性为客户承诺 | 改造成本高,且现状本身具有客户价值 | 产品 |
即:1990 年代的硬件使”静态、粗粒度、可预测”成为最优解,Volcano 理论提供了实现它的最短路径,Oracle 的产品架构则使这条路径延续至今。morsel 需要 many-core、NUMA、廉价线程三者同时具备,才既有必要也有可能。
2.5 硬件变化后的回归验证
上述解释有一个来自 Oracle 自身的验证:当硬件条件具备后,它开始向 morsel 方向部分靠拢。
| 版本 | 特性 | 对应的 morsel 思想 |
|---|---|---|
| 11g | In-Memory Parallel Execution(热数据缓存进各节点 SGA,进程扫描本地缓存) | 数据本地性 |
| 12c | Automatic DOP(优化器自动计算并行度) | 弹性并行度(部分) |
| 12c | Parallel Statement Queuing(并发查询排队,资源满足后放行) | 并行度是分配问题 |
| 12c | Adaptive Plans(运行期按实际行数切换计划) | 运行期自适应 |
| 12c+ | 线程模式(Linux 上可用多线程替代多进程) | 线程成本下降 |
但它未跨过最后一步,原因是 exchange 算子骨架、优化器代价模型、进程模型三层地基仍在。这反向说明:morsel-driven 不是可以增量叠加的特性,而要求执行器从任务模型开始重建。DuckDB 得以实现得较为完整,前提是它从 2018 年开始重新设计。
2.6 跨机场景为何仍采用 plan-driven
同一逻辑可以回答另一个问题:Spark、Greenplum、Trino 至今仍是 plan-driven 的原因。morsel-driven 是共享内存单机技术,跨节点存在五条结构性障碍。
其一,没有共享内存即没有全局工作队列。 morsel 模型的基础是所有线程可原子地从同一无锁队列取任务:
共享内存机器:                     shared-nothing 集群:
┌──────────────────────┐         ┌──────┐        ┌──────┐
│  morsel 队列          │         │Node 0│ ──网络─►│Node 1│
│  [m][m][m][m][m]     │         │ queue│        │ queue│
│   ▲  ▲  ▲  ▲         │         └──────┘        └──────┘
│  T0 T1 T2 T3         │         无共享队列;跨网络传一个 morsel
│  任意线程取任意 morsel │         需 μs~ms 级,比本地一次 CAS 高数千倍
└──────────────────────┘
在 morsel 粒度上做跨节点动态分发,调度开销会抵消全部收益。
其二,计算位置由数据位置决定。 shared-nothing 中 orders 位于节点 {0,2}、lineitem 位于 {1,3},连接时必须在编译期决定 exchange 的位置与形态(co-located / repartition / broadcast)。这是基于静态分区元数据的全局代价决策,无法由单个线程在本地临时作出。
其三,网络通道是需要预建的重量级资源。 跨节点 exchange 需在执行前建立连接、缓冲区与流控,producer/consumer 拓扑必须预先确定,不存在轻量通道用于临时窃取其他节点的工作。
其四,死锁与流控。 若跨节点的 pipeline 调度同样动态化,容易出现环形等待(A 阻塞于向 B 发送,B 阻塞于向 A 发送)。静态计划与有序 pipeline 阶段从结构上排除该问题。
其五,故障域。 每个节点在计划中角色固定,节点失效即重跑对应 fragment;动态 morsel 调度会显著提高失败恢复的复杂度。
因此,跨机场景下 plan-driven 仍然是正确答案,morsel-driven 是单机共享内存的解法。这也是 DuckDB 能够采用它、而 MPP 集群不能的原因。
3 many-core 场景下 Exchange 的四个失配点
将第 1 节的硬件与第 2 节的模型合并考察:当核数由 8 增至 128、NUMA 由个例变为标配,Exchange 赖以成立的前提不再自动满足。以下四个场景是它失去优势的位置。
3.1 并行度只能在编译期估算
Exchange 要求优化器在看到数据之前确定并行度,可用信息仅为统计信息。估偏有两种形态:
- 估大:小表被切成 64 份,每份数百行,线程启动、状态初始化、结果汇聚的开销超过实际计算;
- 估小:实际数据量为估算的 10 倍,8 个线程承担 64 个线程的工作量,其余 56 核空转。
更关键的是运行期环境本身会变化:计划生成时有 64 核空闲,实际执行时可能已有 5 条查询在运行。静态 DOP 对此不作响应。
3.2 静态划分与数据倾斜
静态划分隐含”每份数据处理代价相同”的假设,实际情况包括:
- 数据倾斜,某个 partition 的 join key 集中命中;
- 谓词选择率不均,一个分区被过滤 99%,另一个全部保留;
- 硬件不均,超线程邻居干扰、频率下降、其他查询争抢核心。
结果是整条 pipeline 的耗时等于最慢分区的耗时。该问题随核数上升而恶化:核越多,出现一个显著偏慢分区的概率越高,即并行度越高,长尾越明显。
3.3 线程饥饿死锁
这一类属于结构性缺陷,无法通过参数调整消除。以 hash join 为例:
线程池仅 4 个线程
probe 侧 4 个任务全部被调度 → 全部阻塞在"等待 build 侧哈希表就绪"
build 侧任务仍在队列中     → 无线程可用
=> 死锁
只要同时满足”线程被任务长期占用”与”任务之间存在依赖”两个条件,风险即存在。Exchange 模型中线程与计划分片绑定,一个线程自始至终服务一个分片,容易落入该条件组合。工程上唯一的规避手段是谨慎编排调度顺序——例如强制 build 任务先于 probe 入队;安全性因此取决于实现者是否每次都排对,是一层易被打破的人为约定,而非模型自带的结构保证。
3.4 NUMA:无法进入代价模型的延迟差
第 1 节已量化:远程内存访问延迟高 1.5–2.5 倍,带宽约为本地一半。Exchange 模型不表达内存所在 node,因此:
- 线程被 OS 调度到任意核,并可能被迁移;
- 数据的 node 归属由 first-touch 的执行位置决定,而该位置不受控;
- 大量扫描退化为跨 socket 远程访问,UPI/QPI 成为瓶颈。
| 情形 | 访问路径 | 结果 |
|---|---|---|
| NUMA-aware | Node 0 线程扫 Node 0 数据、写 Node 0 缓冲 | 全本地访问,带宽可用满 |
| NUMA-oblivious | Node 0 线程扫 Node 1 数据、写 Node 1 缓冲 | 全远程访问,带宽减半、延迟翻倍、互联饱和 |
这项开销无法进入代价模型:同一计划、同一份数据,两次执行可能因线程落点不同而产生成倍差异。plan-driven 的核心承诺是可预测性,而 NUMA 直接削弱了这一承诺。
3.5 共同原因
四个失配点指向同一原因:
Exchange 模型在信息最少的时刻(编译期)作出了最需要信息的决策(并行度与数据分配)。
而 many-core 场景下最关键的信息——此刻有多少核空闲、这块数据的实际行数、这一页内存位于哪个 node——只有运行期可知。
4 Morsel-Driven 的机制
论文的解法可以概括为一句话:把并行度从计划里移除,改由运行期的任务领取行为隐式决定。落到机制上是五件事。
4.1 并行度不再是计划属性
morsel-driven 的计划中没有 DOP 字段。执行时的做法是:数据被切成固定大小的 morsel(约十万行),所有 morsel 挂在一个共享结构上;固定数量的 worker 线程(等于硬件线程数)循环从中领取一个 morsel、处理完、再领下一个。
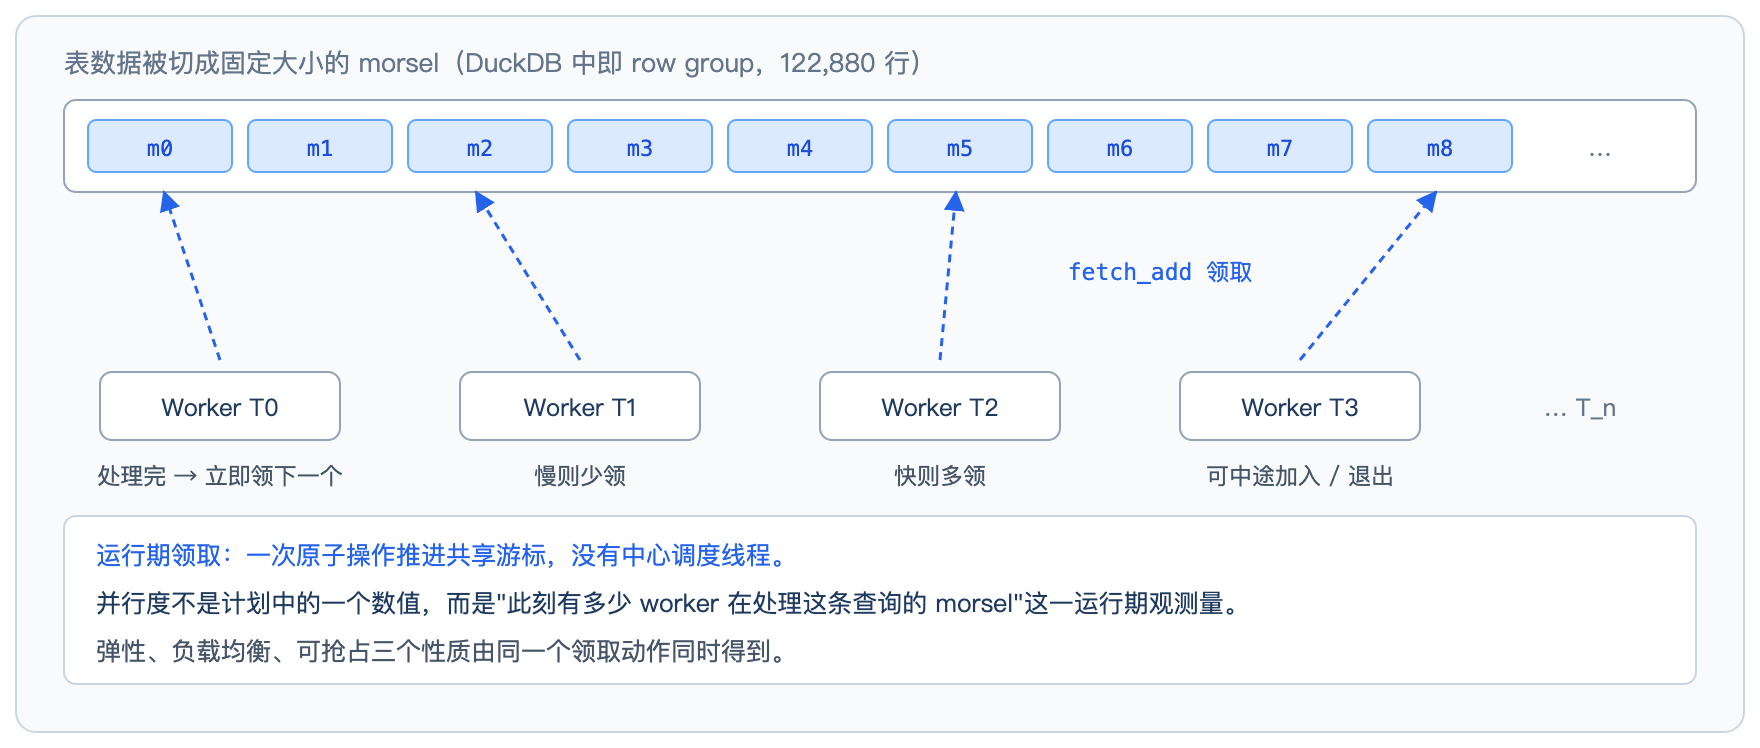
图 3 morsel-driven 执行:并行度是运行期领取行为的结果
由此,并行度不再是一个被设定的数值,而是”当前有多少 worker 正在处理这条查询的 morsel”这一运行期观测量。三个性质随之成立:
- 弹性:核忙则领得慢,核闲则领得快,无需任何显式调节;
- 自动负载均衡:处理快的线程领到更多 morsel,倾斜由领取速度自行吸收;
- 可抢占:morsel 是天然的检查点,一个 morsel 处理完即可让出线程。
4.2 dispatcher 是无锁数据结构,不是线程
论文 §3 明确指出:dispatcher 被实现为一个无锁数据结构,其代码由请求任务的 worker 自己执行,不存在专门的调度线程或调度核心。
这条设计的必要性可以从反面看。若 dispatcher 是独占一个核的线程,代价包括:
| 项 | 影响 |
|---|---|
| 核占用 | 32 核机器损失 1 核,约 3% 算力用于分发 |
| 上下文切换 | 每次取任务需一次线程间通信与两次切换,morsel 处理时间本身仅数百微秒 |
| 单点串行 | 32 个 worker 的取任务请求全部序列化到一个线程上 |
| 缓存迁移 | 调度决策与实际执行在不同核上,元数据反复跨核 |
因此实现形态是”worker 自己走进调度逻辑”:调用 dispatcher->getMorsel(),在无锁结构上做一次 CAS 取到下一个 morsel 区间,随即返回处理。分发过程不发生跨核通信。DuckDB 沿用了同一形态——TaskScheduler 也不是线程,而是一组队列加同步原语。
准入机制。 与之配套的是任务的可见性规则:只有依赖已满足的 pipeline job 才会进入 pending 列表。worker 从 pending 列表取到的任务一定可以立即执行到底,不会中途阻塞等待另一个任务的结果。
回到 3.3 的死锁场景:它成立的前提,是 probe 任务在 build 完成前就被线程领取,于是线程全部卡在”等待 build 侧哈希表”上,反而没有线程去执行仍在排队的 build。准入机制抽掉了这个前提——依赖未满足的 probe 任务不会进入 pending 列表,worker 永远领不到它;任一时刻能被领取的只有当下即可跑到底的任务(此时是无依赖的 build)。没有线程会被一个注定阻塞的任务占住,死锁的前提便无从形成。这也是它与 Exchange 模型的结构性差别:后者靠人为把调度顺序排对来规避,排错即复现;准入机制让这类任务从源头上不可领取,不依赖约定。
由此还得到一个推论:QEPobject(论文中的查询执行状态对象)是被动的状态机,只负责记录”哪些 pipeline 已完成、哪些依赖已满足”,本身不驱动任何执行。推进的动作发生在 worker 完成一个任务、回来更新计数的那一刻。DuckDB 的 Event / Executor 是同一思路的实现,见 5.7。
4.3 morsel 边界上的协作式抢占
任务在 morsel 边界结束时,其全部状态(已处理到哪、中间结果放在何处)都在显式的状态对象里,不在 C++ 调用栈上。这带来一个 Exchange 模型不具备的能力:同一个逻辑任务的后续部分可以由另一个线程继续执行。
时刻 t0   Thread 3 处理 morsel #17(属于任务 A)
时刻 t1   morsel #17 结束,Thread 3 让出 → 转去执行优先级更高的查询
时刻 t2   Thread 7 领到任务 A,从 morsel #18 继续
由此,高优先级查询无需等待长查询结束,只需等待一个 morsel(数百微秒到数毫秒)。这是抢占,只不过抢占点由代码显式选定,而非由时钟中断强制插入。
4.4 morsel 尺寸
论文给出的经验值是约 100,000 元组,取值受两侧约束:
| 方向 | 约束 |
|---|---|
| 过小 | 调度次数上升,原子操作与队列开销占比升高;morsel 内部无法摊薄启动成本 |
| 过大 | 抢占延迟变长,负载均衡变粗,尾部一个大 morsel 可能拖住整条 pipeline |
十万行的量级使单个 morsel 的处理时间落在百微秒到毫秒区间:既远大于一次原子操作(纳秒级),也远小于人可感知的延迟。DuckDB 的对应取值是 row group 122,880 行,以及执行片段(任务运行中检查是否该让出线程的抢占间隔,即 4.3 抢占点的粒度)102,400 行,与该量级一致,见 5.3。
4.5 三个分配目标为何相互冲突
论文对 morsel 分配提出三个目标:
- NUMA 局部性——morsel 尽量分给数据所在 node 上的线程;
- 完全弹性——线程可随时加入或退出,不影响正确性;
- 同步收尾(photo finish)——同一 pipeline 的所有线程尽量同时结束,减少尾部空转。
三者彼此冲突,无法同时取到最优:坚持局部性会导致某个 node 的 morsel 用尽后本地线程空闲,而其他 node 仍有剩余;此时若允许跨 node 窃取,收尾更整齐但引入远程访问。论文的处理方式是分层——优先本地,本地耗尽后允许窃取远程 morsel,即”局部性优先,弹性兜底”。
4.6 NUMA 感知的四个组成部分
论文的 NUMA 方案由四项配合构成,缺一项则收益下降:
| 组成 | 作用 |
|---|---|
| 线程绑核 | worker 永久绑定到 socket,插槽归属静态可知 |
| first-touch | 线程首次写入决定页归属,中间结果自动本地 |
| 亲和分发 | dispatcher 优先把 morsel 分给数据所在 node 的线程 |
| 按连接键同分区 | 参与连接的两表用同一哈希函数分区到相同 node,使连接双方共处一地 |
第四项还有一个细节:表分区所用的哈希函数与后续 hash join 构建哈希表所用的函数相同。因此连接时不必重新计算分区归属——同一个 key 在装载时落到 Node k,在连接时也一定落到 Node k 的哈希表分片,NUMA 局部性由数据布局本身保证,而非依赖运行期判断。
论文同时给出了这套机制的性质界定:它是有益但非决定性的。分区是性能优化而非正确性约束——即使输入分布与连接键完全无关(例如 round-robin 分区),执行结果依然正确,只是跨 node 访问增多。这一性质是 DuckDB 得以裁掉整块 NUMA 逻辑而保持模型完整的原因。
4.7 小结:四个失配点如何被逐一化解
第 3 节列出了 Exchange 在 many-core 下不再适配的四个场景(即”失配点”),第 4 节逐一给出了 morsel-driven 的应对机制。两者一一对应——左列是问题,右列是解法:
| 第 3 节的失配点(Exchange 的问题) | 第 4 节的机制(morsel-driven 如何化解) |
|---|---|
| 3.1 编译期确定并行度 | 计划中无 DOP,并行度是运行期领取行为的结果 |
| 3.2 静态划分与倾斜 | morsel 运行期动态领取,快的线程多领 |
| 3.3 线程饥饿死锁 | 准入机制只放行依赖已满足的任务,结构上不可能发生 |
| 3.4 NUMA 延迟差 | 绑核 + first-touch + 亲和分发 + 同分区,四项配合 |
5 DuckDB 的实现与取舍
5.1 定位
DuckDB 是进程内嵌入式的单机分析型数据库:无独立服务进程,以库的形式链接进宿主进程(Python、R、Java、CLI),单文件存储,列式 + 向量化执行。它的目标场景是一台机器上的分析查询,与 HyPer 论文的前提(共享内存 many-core 单机)完全一致——这是它能够采用 morsel-driven 的前提,也是取舍的判断依据。
5.2 继承论文的部分:核心机制与四个关键常量
DuckDB 完整继承了论文执行模型的核心机制:pipeline 拓扑在编译期确定、任务在运行期动态领取、morsel 边界抢占、thread-local 中间状态、无锁任务队列、准入式依赖推进。落到代码上,四个常量决定了整套粒度体系:
| 常量 | 值 | 位置 | 含义 |
|---|---|---|---|
DEFAULT_STANDARD_VECTOR_SIZE |
2048 | src/include/duckdb/common/vector_size.hpp:16 |
向量化执行的批大小 |
DEFAULT_ROW_GROUP_SIZE |
122880 | src/include/duckdb/storage/storage_info.hpp:23 |
row group 行数,即 morsel 的物理实体(= 60 × 2048) |
PARTIAL_CHUNK_COUNT |
50 | src/include/duckdb/parallel/pipeline.hpp:28 |
一个执行片段处理的 vector 数 |
| zstd frame | 2048 值 | src/storage/compression/zstd.cpp:45 |
压缩帧与 vector 对齐,使解压不跨帧 |
其中 PARTIAL_CHUNK_COUNT = 50 意味着一次执行片段处理 50 × 2048 = 102,400 行,与论文的十万行量级一致。这一数值不是巧合,而是同一组硬件约束下的收敛结果。
5.3 粒度的三层嵌套
理解 DuckDB 执行器的关键是区分三个不同用途的粒度,它们层层嵌套:
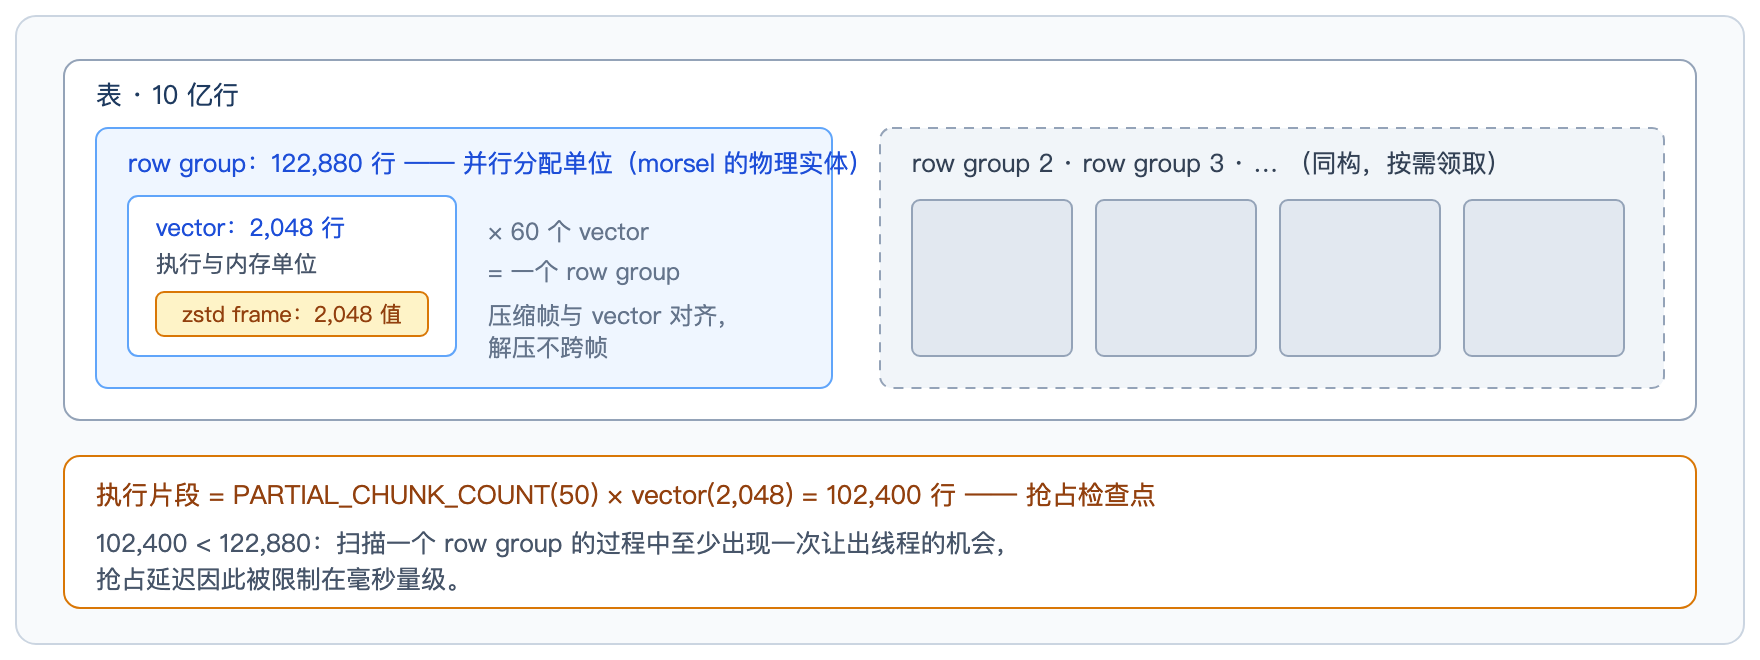
图 4 DuckDB 的三层粒度嵌套与执行片段
三者的分工是明确的:row group 决定”数据怎么切给线程”,vector 决定”CPU 一次处理多少”,执行片段决定”多久回来看一次是否该让出线程”。执行片段略小于一个 row group(102,400 < 122,880),意味着扫描一个 row group 的过程中至少有一次让出机会,抢占延迟被限制在毫秒量级。
5.4 两层划分:任务数与数据分片数解耦
DuckDB 的并行度体现为两个独立的量,二者不相等:
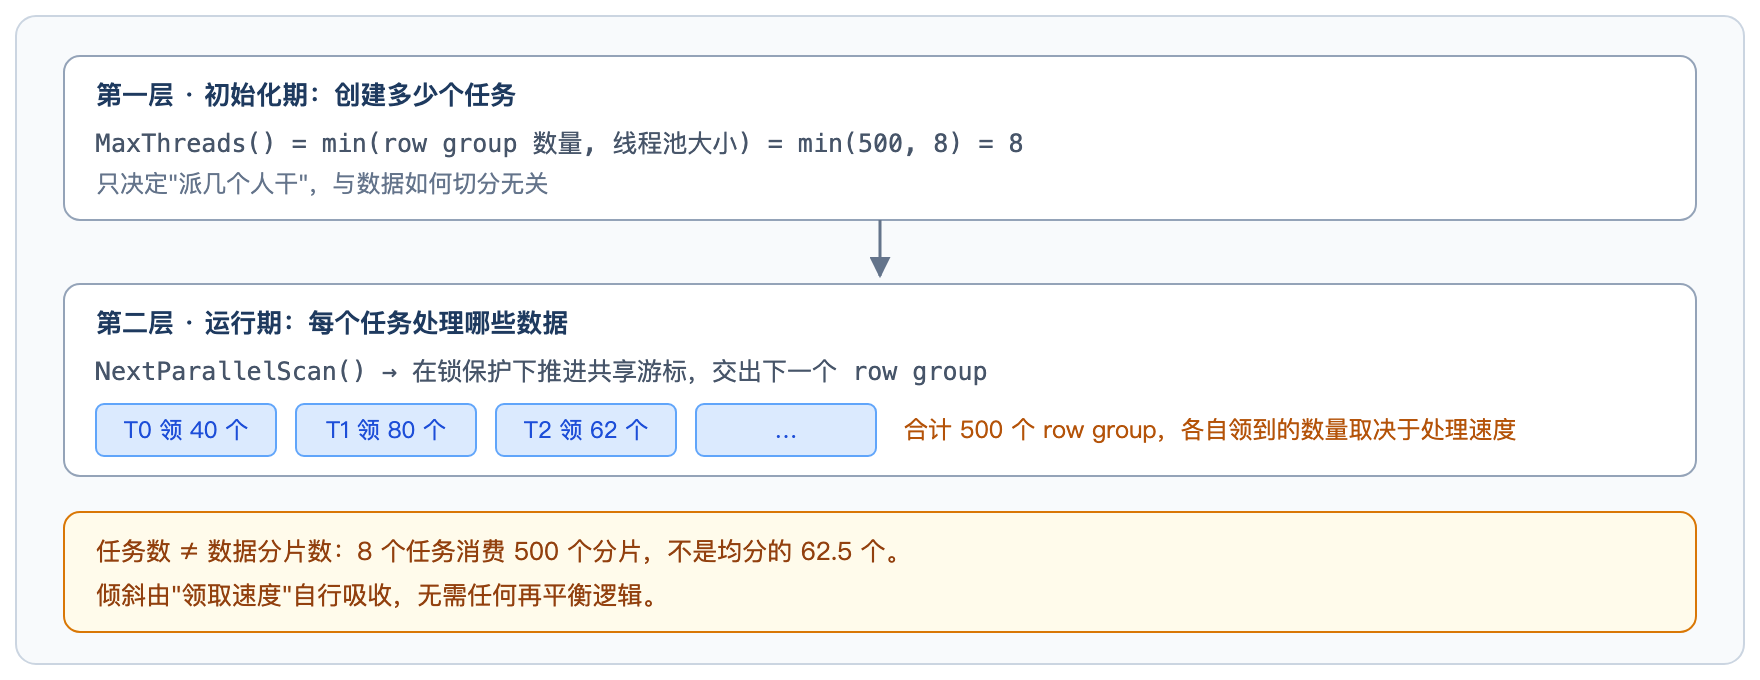
图 5 两层划分:任务数与数据分片数解耦
举例:一张 500 个 row group 的表在 8 线程机器上执行扫描,MaxThreads() 给出 501,被调度器线程数取小为 8,即创建 8 个 PipelineTask;这 8 个任务在运行期共同消费 500 个 row group,各自领到的数量取决于处理速度,可能是 40 / 80 / 62 …… 而不是均分的 62.5。
支撑这一行为的是三处代码:DataTable::MaxThreads()(src/storage/data_table.cpp:271)按总行数除 row group 大小给出上限;Pipeline::ScheduleParallel()(src/parallel/pipeline.cpp:122-134)将其与 NumberOfThreads() 取小后交由 LaunchScanTasks 创建任务;RowGroupCollection::NextParallelScan()(src/storage/table/row_group_collection.cpp:209)在 lock_guard<mutex> l(state.lock) 保护下推进共享游标并交出下一个 row group。另外,src/function/table/table_scan.cpp:267-290 的 do/while 循环使任务在当前 row group 耗尽后立即继续领取,无需回到调度器。前两者决定”morsel 从哪来”,后者决定”任务如何连续领取”。
调度器侧的 NumberOfThreads() 来自 DBConfig::GetSystemMaxThreads()(src/main/config.cpp:528):取 std::thread::hardware_concurrency() 的逻辑核数,Linux 上再经 CGroups::GetCPULimit() 按 cgroup 的 CPU 配额截断。一台 256 逻辑核的机器上默认即 256。这也是区分物理核与逻辑核的实际意义所在——DuckDB 的默认并行度取逻辑核数,不是物理核数。
5.5 全局队列取代 per-socket 队列
论文为每个 socket 维护一个 morsel 队列,以实现亲和分发。DuckDB 采用单一全局队列(src/parallel/task_scheduler.cpp:39-40):
using concurrent_queue_t    = duckdb_moodycamel::ConcurrentQueue<shared_ptr<Task>>;
using lightweight_semaphore_t = duckdb_moodycamel::LightweightSemaphore;
ConcurrentQueue 是无锁 MPMC 队列,LightweightSemaphore 负责在无任务时让线程休眠、有任务时唤醒,避免忙等。选择单队列的代价是失去 node 亲和性,收益是实现简单且没有跨队列窃取逻辑;对绝大多数 DuckDB 部署形态(笔记本、单 socket 服务器、容器内若干核)而言,node 亲和性并不存在可优化的空间。
5.6 NUMA 感知:裁剪掉的部分
DuckDB 只实现了论文 NUMA 四件套中的第一项,且带有条件:
// src/parallel/task_scheduler.cpp:501
static void SetThreadAffinity(thread &thread, const int &cpu_id) {
#if defined(__GLIBC__)
    cpu_set_t cpuset;
    CPU_ZERO(&cpuset);
    CPU_SET(cpu_id, &cpuset);
    pthread_setaffinity_np(thread.native_handle(), sizeof(cpu_set_t), &cpuset);
#endif      // 非 glibc 平台:空实现,线程不绑核
}

// src/parallel/task_scheduler.cpp:541-544
static constexpr idx_t THREAD_PIN_THRESHOLD = 64;
const auto pin_threads = db.config.options.pin_threads == ThreadPinMode::ON ||
                         (db.config.options.pin_threads == ThreadPinMode::AUTO &&
                          std::thread::hardware_concurrency() > THREAD_PIN_THRESHOLD);
即:绑核仅在 glibc 平台有实现(实践上即 Linux 的 glibc 发行版,macOS、Windows、musl 均为空实现);默认的 AUTO 模式下还要求硬件线程数超过 64,也可由 pin_threads 选项显式开关。逐项对照:
| 论文机制 | DuckDB | 说明 |
|---|---|---|
| 线程绑核 | 部分实现 | 仅 glibc 平台;AUTO 模式下需硬件线程数超过 64 |
| first-touch 本地分配 | 间接获得 | 绑核生效时随之成立,未绑核时依赖 OS 调度 |
| morsel 亲和分发 | 未实现 | 单一全局队列,不区分 node |
| 按连接键同分区 | 未实现 | 存储层不做 NUMA 分区 |
这一裁剪的合理性来自 4.6 的性质界定:NUMA 分区是性能优化而非正确性约束,缺失它不改变结果,只损失局部性收益。而对 DuckDB 的典型部署形态,该收益本身有限;THREAD_PIN_THRESHOLD = 64 是这一判断的量化表达:只有硬件线程数进入需要考虑 NUMA 的量级,才付出绑核的代价。
在四个失配点上,DuckDB 完整解决了 3.1、3.2、3.3,对 3.4 只做了部分处理。三个结构性问题都在模型层面消除,而 NUMA 是一个可以按部署形态权衡的性能项。
5.7 事件机制:依赖推进不占用线程
pipeline 之间的依赖(如 hash join 的 build 必须先于 probe)在 DuckDB 中由事件表达。关键实现是计数式触发(src/parallel/event.cpp:14-17):
void Event::CompleteDependency() {
    idx_t current_finished = ++finished_dependencies;
    if (current_finished == total_dependencies) {
        // 依赖全部满足,调度自身
        Schedule();
    }
}
依赖计数归零的那个线程顺手调度后继事件,整个过程中没有任何线程处于等待状态。这与 4.2 的准入机制是同一件事的两面:依赖未满足的任务不进入队列,依赖满足的瞬间由完成者推进。
6 全局视角
6.1 五层执行栈
演进的终点是代码,DuckDB 的执行器在结构上分为五层。上三层是执行框架,下两层是算子实现:
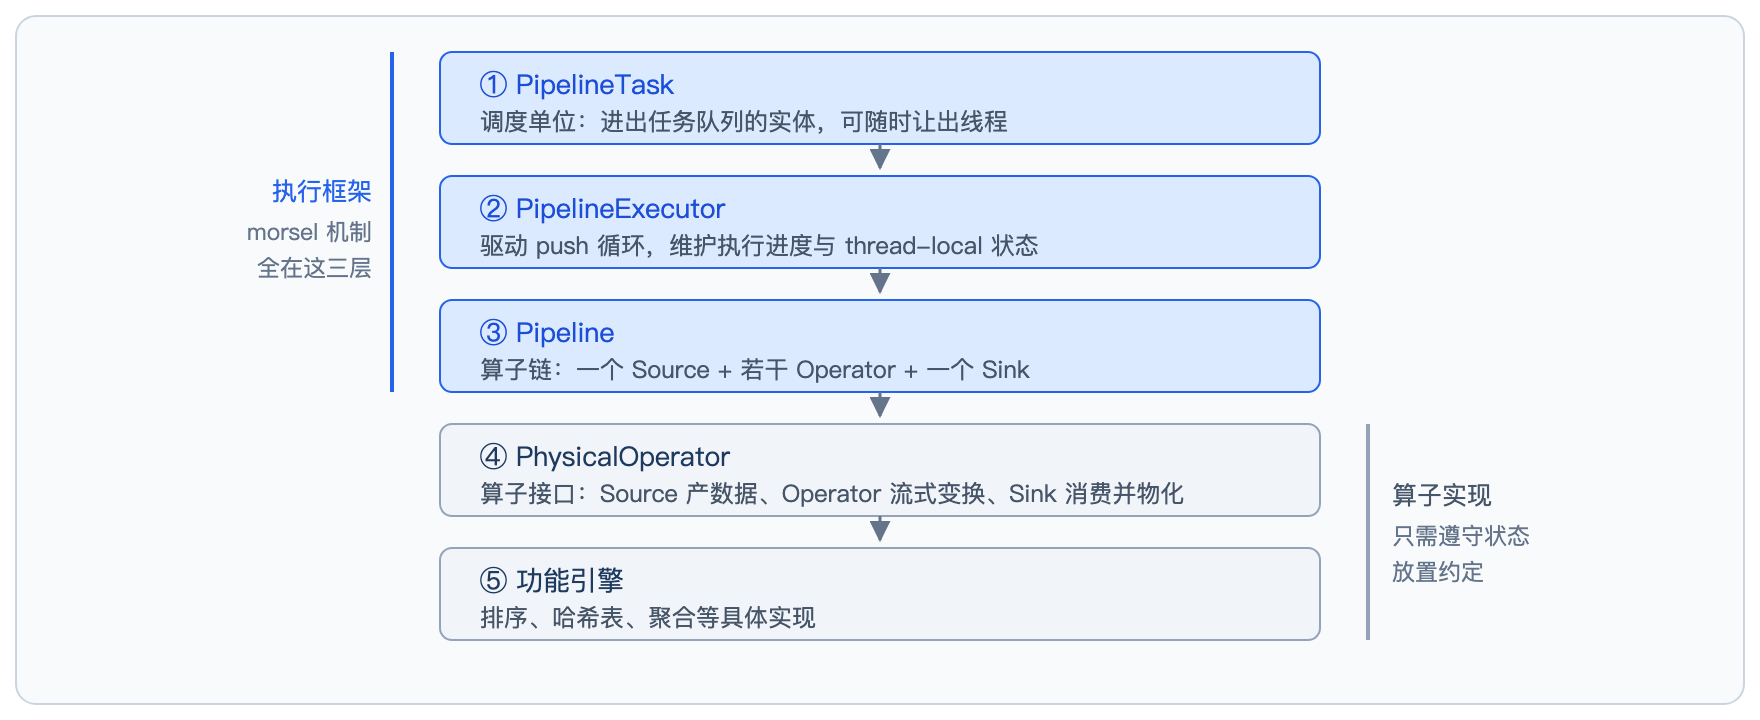
图 6 五层执行栈:morsel 机制集中在上三层,算子实现不感知并行
morsel-driven 的全部机制位于上三层:任务怎么入队、数据怎么领取、状态怎么隔离,全在 PipelineTask / PipelineExecutor / Pipeline 这三个类里。下两层不感知并行,算子实现者只需遵守状态放置约定,不必处理调度与线程。这也是并行算子在 DuckDB 里写起来不复杂的原因。
6.2 两个需要区分的概念
Task ≠ Operator。 任务是调度单位,一个任务负责驱动整条 pipeline 的一段数据;算子是计算单位,描述一次数据变换。一个任务的执行会依次调用链上的多个算子,两者不是同一维度的概念。
任务数 ≠ 数据分片数。 如 5.4 所述,任务数在初始化期由 MaxThreads() 给出,数据分片在运行期被领取,二者数量无关。
算子内部状态的放置规则由此确定:并行算子把中间结果写入 thread-local 状态,仅在合并阶段加锁汇总——这是 DuckDB 中所有并行算子(sort、hash aggregate、hash join)的统一模式。
6.3 小结
DuckDB 没有沿用 Volcano 的并行化路径,原因不在于 Exchange 本身实现得不好,而在于它成立的前提——线程数在编译期已知、数据划分在编译期确定——在 many-core 单机上不再成立。morsel-driven 把这两个决定推迟到运行期,弹性、负载均衡、可抢占三个性质由同一个领取动作一并得到;代价是并行度不再是计划里的一个数值,而要到运行期才能观测。
DuckDB 在此基础上又做了一次取舍:保留调度与领取的核心机制,舍弃 NUMA 感知,用四行代码的并行度推导替代了一整套拓扑感知分发逻辑。论文把 NUMA 部分定为”beneficial but not decisive”,这一判断给了这种裁剪空间。