树怎么变成一组流水线:DuckDB 的 Pipeline 切分
Author: 杨泽(勉仁)
本文拆解 DuckDB 执行器启动前的第一道工序:把一棵 PhysicalOperator 树切成一组可并行的 pipeline,并在切分的同时定下它们之间的先后顺序。
插播一个广告:PolarDB PostgreSQL 的 分析引擎 基于 DuckDB,同时提供了列存索引(向量化引擎)和云原生 DuckDB 列存表。本文拆解的这道“树变流水线”的切分工序,正是这些特性上每条分析查询执行前的必经之路。
0 结论
物理计划是一棵树,pipeline 是一条线性链。执行器启动前要做的第一件事,就是把树变成一组链,并记下链与链之间的先后顺序。
这道工序的规则可以压缩成三条:
- 切分点是
IsSink()为true的算子,也就是阻塞算子。同一个算子对象会在相邻两条链里担任不同角色:对上游那条链是 source,对下游那条链是 sink。 - 切分规则不在一个集中的切分器里,而由算子自己实现。
PhysicalOperator::BuildPipelines是虚函数,基类给出源/切分/流式三条路径,join、union、CTE 算子各自override。 - 依赖是在递归下降切分的过程中顺手登记的,不是事后分析出来的。它跟随树的递归结构生成,因此天然无环。
切分产物里没有任何并行度信息。一条 pipeline 用几个线程跑,计划里不写,要到运行期才决定——这正是上一篇文章讲的 morsel-driven 与 plan-driven 的区别。
1 从 SQL 到 Pipeline:形态转换
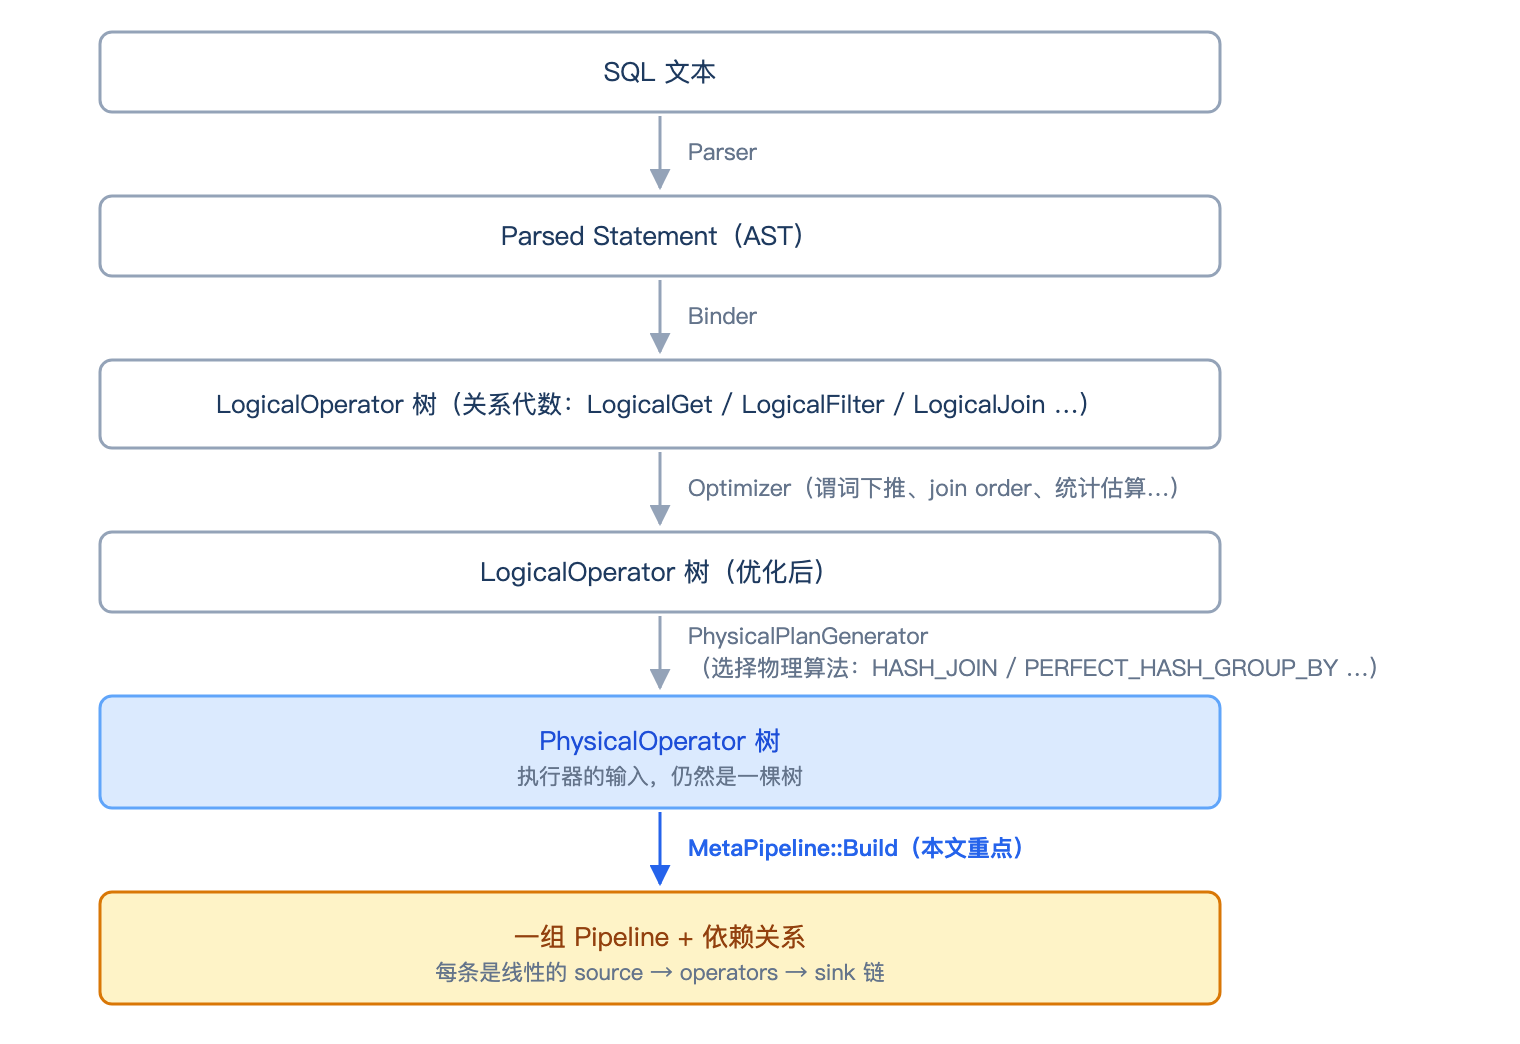
图 1 从 SQL 文本到一组 Pipeline:最后一步 MetaPipeline::Build 是本文的主题
要做这层转换,是因为并行的边界并不落在树的分叉上,而落在阻塞算子上。一条纯流式的链上,数据从 source 一路流到 sink,中途不需要全局同步,N 个线程可以同时开跑;而阻塞算子必须等下方全部算完才能向上供数,这个等待跨不过去。于是”两个阻塞点之间的最大连续区间”就成了一个天然的切分单位,也就是 pipeline。
入口在 Executor::InitializeInternal:
// src/parallel/executor.cpp:392-396
// 构建 pipeline,并把它们“就绪”
PipelineBuildState state;
auto root_pipeline = make_shared_ptr<MetaPipeline>(*this, state, nullptr);
root_pipeline->Build(*physical_plan);
root_pipeline->Ready();
这里第一次出现的 MetaPipeline 不是某条具体的流水线,而是比 pipeline 高一层的分组单位:一组共享同一个 sink 的 pipeline。最典型的场景是 UNION——多个分支各自成链、却写进同一个下游算子;JOIN 的 build/probe 两条链也靠这套分组机制定序。第 4 节会展开共享 sink 的几类场景,并说明子分组何时会长出新的一层。叫 “meta” 是因为它自己不承载数据流,管的是更高一层的事——组内 pipeline 怎么建、子分组怎么挂、组间依赖怎么登记。构建正是从根分组出发,随计划树递归展开的。
构造函数的第三个参数,就是这组 pipeline 共享的 sink。根这一组传的是 nullptr,因为它上面再没有 sink 了:以 SELECT 为例,计划树真正的根是结果收集器(PhysicalResultCollector),它在构建时把自己设为顶层 pipeline 的 source,同时另起一个子 MetaPipeline、以自己为共享 sink 去构建下方的查询计划(src/execution/operator/helper/physical_result_collector.cpp:54-67)。数据向上汇进收集器,再由顶层 pipeline 直接取回客户端,不落入任何阻塞算子。所以 nullptr 标记的正是整棵树的出口。
2 Pipeline:三段式线性结构
先看切出来的产物。Pipeline 的核心成员只有三个:
// src/include/duckdb/parallel/pipeline.hpp:132-137
//! 本条 pipeline 的数据源
optional_ptr<PhysicalOperator> source;
//! 中间算子链(流式变换)
vector<reference<PhysicalOperator>> operators;
//! 数据的去处,例如一个待构建的哈希表
optional_ptr<PhysicalOperator> sink;
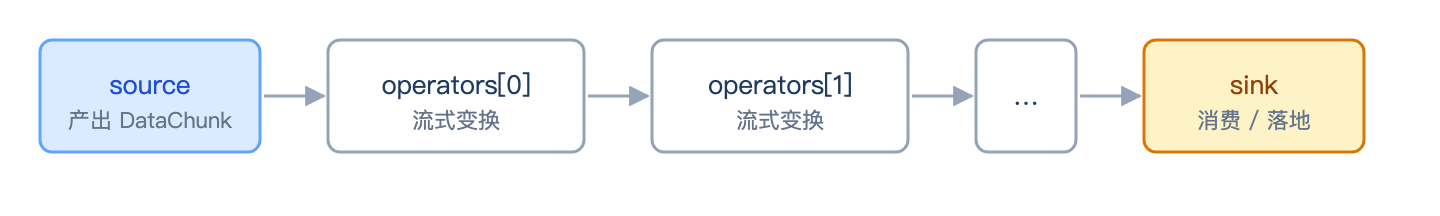
图 2 Pipeline 的三段式结构:source 产数据,operators 逐级变换,sink 消费
- source:链头,产出
DataChunk。可以是表扫描,也可以是一个已经完成的阻塞算子——比如排好序的PhysicalOrder就是它上游那条链的 source。 - operators:链中间的流式变换,filter、projection、streaming join probe 等。
- sink:链尾的消费者。sink 是切分点的标志物:一条 pipeline 之所以存在,就是因为它的数据要落到某个 sink 里。
紧接着的三个成员记录结构关系:
// src/include/duckdb/parallel/pipeline.hpp:139-145
//! 全局 source 状态
unique_ptr<GlobalSourceState> source_state;

//! 父 pipeline:等本条跑完才能开始的那些
vector<weak_ptr<Pipeline>> parents;
//! 本条依赖的 pipeline
vector<weak_ptr<Pipeline>> dependencies;
source_state 是全局的:同一条 pipeline 上的 N 个任务共享它来领取数据,morsel 就从这里分发。dependencies 与 parents 双向记录顺序,调度阶段构造事件 DAG 时依据的就是它们。这两个字段有两个容易误会的地方,需要先说清楚。
其一,parents 的”父”是计划树里的父,不是时间上的父。 源码注释原话是 “The parent pipelines (i.e. pipelines that are dependent on this pipeline to finish)”(src/include/duckdb/parallel/pipeline.hpp:142-143)——即”等本条跑完才能开始的那些”。计划树根在上、叶子在下,数据从叶子流向根:下方的链先跑、把 sink 填满,上方的链后跑、从 source 取数。上方的链更靠近根,按树的辈分就是”父”。命名跟着树结构走,与执行顺序正好相反——父反而后跑。MetaPipeline::parent 与调度层的 Event::parents 沿用同一约定。
其二,同组内部的先后,不记在这两个字段里。 字段里记的是跨组的边:常规写入点是 CreateChildMetaPipeline(第 5 节)——”父组这条链等子组跑完”;此外递归 CTE、物化 CTE 等特定算子也会写(src/execution/operator/set/physical_recursive_cte.cpp:311、src/execution/operator/scan/physical_column_data_scan.cpp:82-96),表达”另一条链把集合灌满之后,本条才能开始扫”。而同组之内链与链的顺序——保序时的 union 分支(第 4 节)、FULL OUTER JOIN 的补扫链等 probe(第 6.1 节)——记在组级的 MetaPipeline::pipeline_dependencies 表里。这两类依赖到调度时才显出差别(src/parallel/executor.cpp:189-218):字段里的跨组边等的是对方的 CompleteEvent——对方所在整组跑完、sink 也 Finalize 完;组表里的边只等对方的 PipelineEvent——对方那条链数据流完即可。
最后还有一个与构建方向有关的细节。pipeline 的构建从计划树的根出发、递归向叶子下降(完整算法第 3 节展开),这个方向决定了 operators 的入链顺序:递归到达某个流式算子时,更靠近 source 的算子还没被访问到,于是被 push_back 进链的是”靠近 sink 的先进”,与数据流方向正好相反。构建结束后统一翻转:
// src/parallel/pipeline.cpp:240-246
void Pipeline::Ready() {
    if (ready) {
        return;
    }
    ready = true;
    std::reverse(operators.begin(), operators.end());   // 把算子链翻回数据流方向
}
这就是 Build() 之后紧跟一个 Ready() 的原因:Build 负责收集,Ready 负责把链的方向掰正。翻转之后 operators[0] 才是紧挨着 source 的那个算子,驱动循环可以从 0 开始逐个往下推。
3 切分算法:BuildPipelines 的三条路径
递归的入口极简,只做一层转发,直接交给算子定义:
// src/parallel/meta_pipeline.cpp:85-89
void MetaPipeline::Build(PhysicalOperator &op) {
    D_ASSERT(pipelines.size() == 1);   // 组里只有构造时创建的那条空 pipeline
    D_ASSERT(children.empty());        // 还没有任何子分组——Build 只作用在全新分组上
    op.BuildPipelines(*pipelines.back(), *this);
}
两条断言校验的是同一个前置条件:Build 拿 pipelines.back() 当作正在构建的当前链,而后续的依赖登记(union 分支继承、child pipeline 等 probe)全部依赖创建顺序。对一个已建过一部分的分组再次调用,依赖会被静默记错,所以用断言在 debug 构建里提前拦住这种误用。
切分规则由算子自己定义。PhysicalOperator::BuildPipelines 是虚函数,基类给出默认的三条路径,join、CTE、union 等特殊算子各自override。
基类默认实现:
// src/execution/physical_operator.cpp:208-238
void PhysicalOperator::BuildPipelines(Pipeline ¤t, MetaPipeline &meta_pipeline) {
op_state.reset();
auto &state = meta_pipeline.GetState();
if (!IsSink() && children.empty()) {
// ① 叶子且非 sink → 它就是这条 pipeline 的 source,递归到底,结束
state.SetPipelineSource(current, *this);
return;
}
if (children.size() != 1) {
// 兜底防线:0 个孩子(无孩子的 sink,如结果收集器)或多个孩子(join/union)
// 都超出线性链形态,这类算子必须自己 override 本函数;
// 走到这里说明漏了 override——是内部编程错误,不是用户 SQL 的问题
throw InternalException("Operator not supported in BuildPipelines");
}
if (IsSink()) {
// ② 阻塞算子 —— 切pipeline
sink_state.reset();
// 对当前 pipeline 来说,这个阻塞算子是数据来源(它算完了才吐数据)
state.SetPipelineSource(current, *this);
// 同时另起一个子 MetaPipeline,以它为 sink,继续往下建
auto &child_meta_pipeline = meta_pipeline.CreateChildMetaPipeline(current, *this);
child_meta_pipeline.Build(children[0].get());
return;
}
// ③ 流式算子:挂进当前 pipeline 的 operators 链,继续往下递归
state.AddPipelineOperator(current, *this);
children[0].get().BuildPipelines(current, meta_pipeline);
}
三条路径对应三种处理方式:
| 路径 | 算子类型 | 处理 | 举例 |
|---|---|---|---|
| ① | 叶子、非 sink | 成为 source,递归终止 |
PhysicalTableScan、PhysicalColumnDataScan |
| ② | IsSink() == true |
切分点:对上是 source,对下另起 pipeline 当 sink | PhysicalHashAggregate、PhysicalOrder、hash join build |
| ③ | 流式算子 | 追加到 operators |
PhysicalFilter、PhysicalProjection、PhysicalLimit |
Sink算子是整套机制的核心。同一个算子对象在两条 pipeline 里担任不同角色:
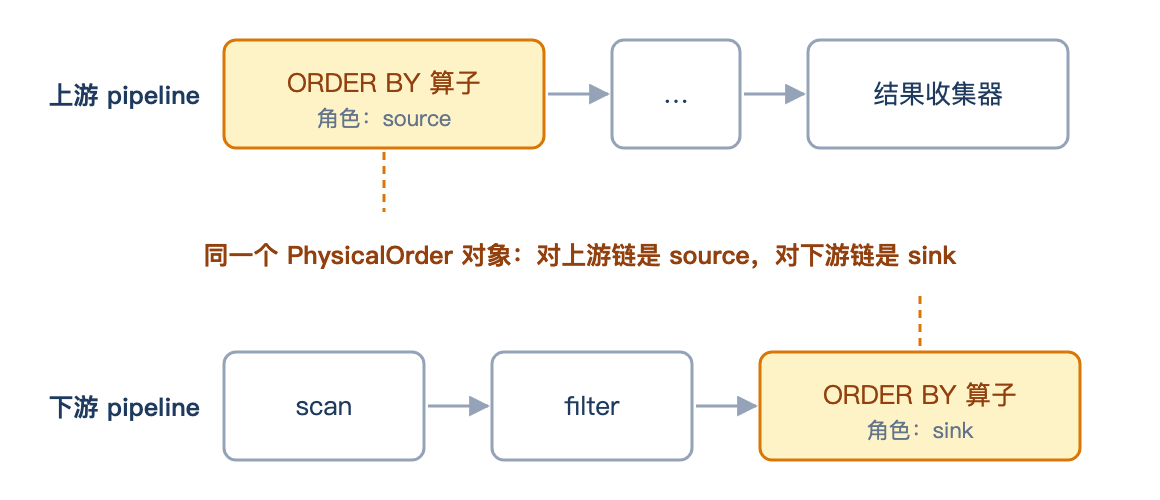
图 3 同一个 PhysicalOrder 对象:对下游链是 sink,对上游链是 source
一个算子同时是上面那条链的 source 和下面那条链的 sink,这就是阻塞点的本质:它必须把下面那条链收完(sink 阶段结束),才能开始给上面那条链供数(source 阶段开始)。算子被划分为 source / operator / sink 三种角色,根源就在这条路径上。
4 MetaPipeline:共享同一个 sink 的一组 pipeline
切出来的是 pipeline,但代码里到处是 MetaPipeline。类注释一句话点明了定义:
// src/include/duckdb/parallel/meta_pipeline.hpp:21-22
//! MetaPipeline 代表一组共享同一个 sink 的 pipeline
class MetaPipeline : public enable_shared_from_this<MetaPipeline> {
多条 pipeline 共享一个 sink,最典型的来源是 UNION:
SELECT * FROM a UNION ALL SELECT * FROM b
两个分支各自是一条独立的流式链,但它们最终写进同一个 sink。这两条链之间没有必然的先后关系,却共享 sink 状态,所以生命周期必须被当成一个整体管理——Finalize 只能在两条链都跑完之后做一次。
共享 sink 的场景不止 UNION,另外两类都出现在 JOIN 里:
- build 子组:build 链另起一个
JOIN_BUILD类型的子 MetaPipeline,sink 就是这个 join 算子本身。当 build 侧自己含有 UNION 或多条链时,这些链就在子组内共享同一个 join sink、共同建同一张哈希表(第 6 节展开)。 - 同组 child pipeline:FULL / RIGHT OUTER JOIN 在 probe 结束后还要扫一遍哈希表,把未匹配的行补输出来。这条补扫链用
CreateChildPipeline挂进 probe 链所在的同一组,与 probe 链共享同一个 sink,但登记了必须等 probe 全部结束的依赖——probe 没跑完,无法知道哪些 build 行没被匹配到(第 6.1 节)。
第一个场景画成图(以 a JOIN (b1 UNION ALL b2) 为例,a 是左表走 probe,b1/b2 是右表走 build):probe 链留在父组,join 对它只是中间算子;两条 build 链在子组里共享 join 这个 sink:
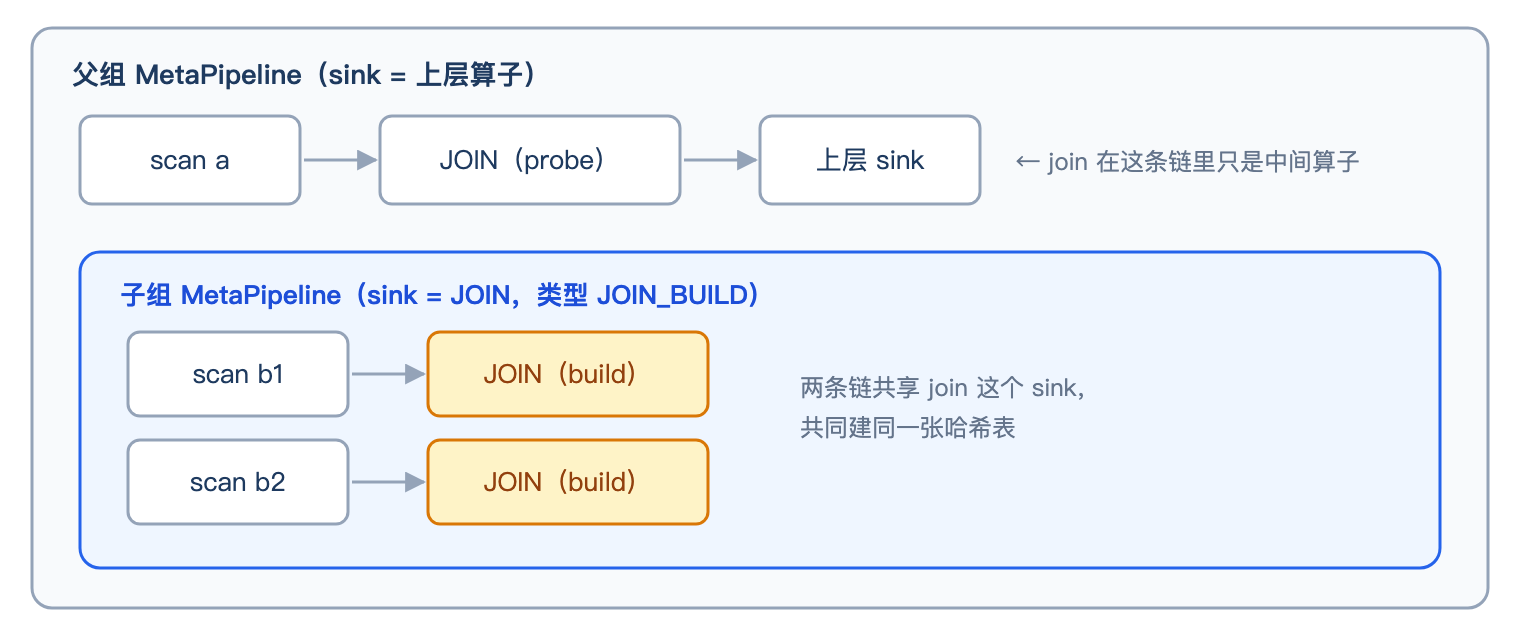
图 4 a JOIN (b1 UNION ALL b2):probe 链留在父组,两条 build 链在子组共享 join sink
第二个场景画成图,以 a FULL OUTER JOIN b ON a.k = b.k 为例:a 是左表走 probe,b 是右表建哈希表,两侧的未匹配行分别在不同阶段补输出:
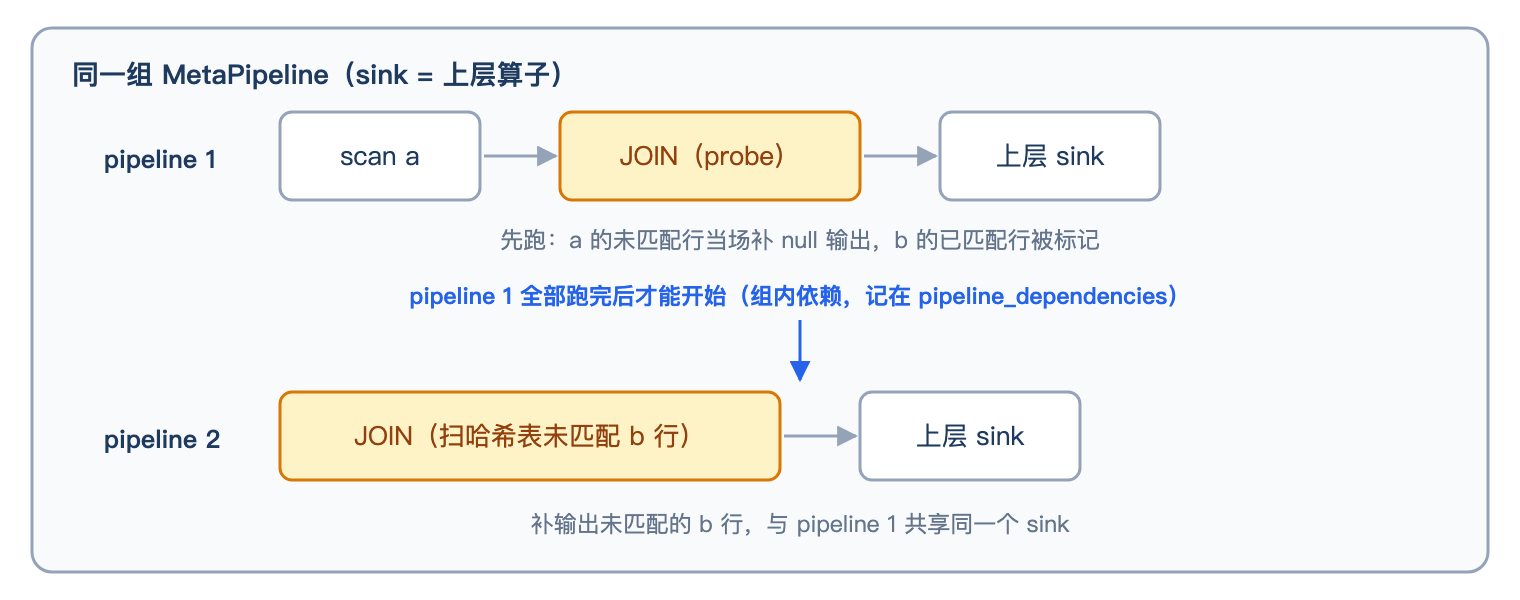
图 5 a FULL OUTER JOIN b:补扫链与 probe 链同组,且必须等 probe 链全部跑完
对照之下,a LEFT JOIN b 用不到补扫语义:需要补输出的只有左表未匹配行,而它们在 probe 流里当场就能输出,右表未匹配行直接丢弃。源码里这个判断就是 PropagatesBuildSide,只对 FULL / RIGHT / RIGHT_SEMI / RIGHT_ANTI 成立(src/common/enums/join_type.cpp:14-17)——即只有”未匹配的 build(右表)行也需要输出”的 join 类型,才真正依赖这条补扫链。
可以看出,”同组”与”子组”对应的定序关系完全不同。组内的定序是弹性的:UNION 分支默认没有先后、可以并发,只有语义要求时才在两条链之间登记先后(如 FULL OUTER JOIN 的补扫链必须等 probe 链跑完)。组间的定序是刚性的:子组必须完全跑完,父组才能开始,没有例外。
组内定序存在从”默认并发”变成”强制串行”的场景。回看三类共享 sink 的场景,带这种切换的只有 UNION:build 子组是组间定序(整组先后,不归这里管),FULL OUTER JOIN 的补扫链是语义上必须串行(probe 没跑完就不知道哪些行未匹配),两者都没有选择余地;只有 UNION 分支默认并发,但一些场景下在构建时被切换成串行。这个开关由 PhysicalUnion::BuildPipelines 算出来:
// src/execution/operator/set/physical_union.cpp:38-58
// order_matters:是否需要在 union 分支之间加上"后一条分支等前一条"的依赖
auto sink = meta_pipeline.GetSink();
bool order_matters = false;
if (!allow_out_of_order) {                    // 会话关闭了乱序执行
    order_matters = true;
}
if (current.IsOrderDependent()) {             // 下游算子依赖顺序
    order_matters = true;
}
if (sink) {
    if (sink->SinkOrderDependent()) {         // sink 对输入顺序敏感
        order_matters = true;
    }
    auto partition_info = sink->RequiredPartitionInfo();
    if (partition_info.batch_index) {         // sink 声明需要 batch index(为什么要串行,见下文)
        order_matters = true;
    }
    if (!sink->ParallelSink()) {              // sink 不支持并行写入
        order_matters = true;
    }
}
五个条件任一成立,order_matters 即为真:会话关闭了乱序执行、下游算子依赖顺序、sink 本身对输入顺序敏感、sink 声明需要 batch index、sink 不支持并行写入。这个布尔值随后决定分支之间是否加依赖:
// src/parallel/meta_pipeline.cpp:217-236(节选)
Pipeline &MetaPipeline::CreateUnionPipeline(Pipeline ¤t, bool order_matters) {
// 新建 union pipeline(batch index 先给 0,之后再置正)
auto &union_pipeline = CreatePipeline();
state.SetPipelineOperators(union_pipeline, state.GetPipelineOperators(current));
state.SetPipelineSink(union_pipeline, sink, 0);
// union pipeline 继承 current 的全部依赖
union_pipeline.dependencies = current.dependencies;
...
if (order_matters) {
// 需要保序,或 sink 不支持并行时,才在两条分支之间加依赖
pipeline_dependencies[union_pipeline].push_back(current);
}
return union_pipeline;
}
于是保序需求把两条本可并发的分支退化成串行的两条分支——性能与语义在这里直接交换。
五个条件里最绕的是”sink 声明需要 batch index”,值得单独展开。batch index 是一套”给数据发座位号”的并行保序机制:构建时,共享同一 sink 的每条 pipeline 分到一段互不重叠的批号区间(base_batch_index = BATCH_INCREMENT × 组内序号,src/parallel/pipeline.cpp:332-337);运行时,每个 chunk 带上”区间基数 + source 内位置”的批号(src/parallel/pipeline_executor.cpp:126-142)。声明 RequiredPartitionInfo().batch_index 的 sink——batch INSERT、batch COPY、保序流式结果收集器、PhysicalLimit——会把并发到达的乱序 chunk 缓存起来,输出时按批号还原逻辑上的先后顺序。数据自带座位号,执行顺序就可以随便并发。
那 sink 自己有还原机制,为什么 union 分支反而要串行?现在这个条件是 2023 年翻转出来的(commit eae16a8526),提交信息给了两条理由。
其一,并行调度 union 分支会打乱最小批号(minimum batch index)的追踪。sink 判断”可以安全输出到哪一批”靠的是最小批号:比它小的批次不会再有数据到来,可以放心输出或落盘。分支 1 的批号区间是 [0, BATCH_INCREMENT),分支 2 是 [BATCH_INCREMENT, 2×BATCH_INCREMENT),两条分支并发时进度没有任何同步:分支 2 先跑完,它的数据批号全都压着水位线,一条也输出不了,只能整体堆在缓存里等分支 1 追上——批号的收支在交错到达下被扰乱,这正是提交信息说的 messes up the minimum batch index。
其二,输出顺序要紧时,分支并发的收益本就有限:串行损失的只是两条分支扫描的重叠,而并发换来的是 sink 缓存的膨胀,得不偿失。
组内的两个问题——pipelines[] 从哪来、链与链怎么定序——到此讲完。把组内、组间两个维度合在一起,MetaPipeline 的层次结构是:
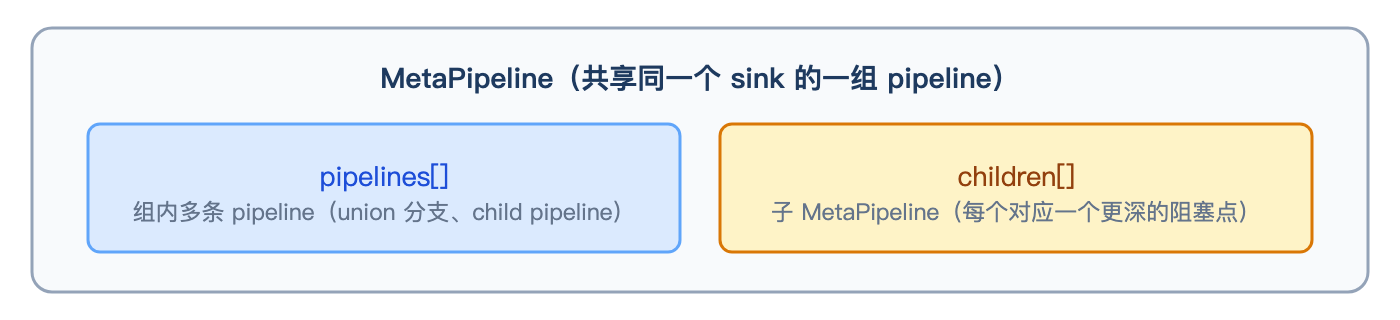
图 6 MetaPipeline 的两个维度:组内 pipelines[] 与组间 children[]
pipelines[] 由前面几类场景填充;children[] 长出新的一层,触发条件只有一个:某个算子当完 sink 之后,还要再当一轮 source——阻塞算子把下方数据全量物化之后,还要作为 source 向上输出,输出的那半段是新一轮 source→sink 链,需要一个新的分组来承载。三类入口都是这个模式,差别只在 sink 是谁、填满之后谁当 source:
- 先物化、后输出的阻塞算子(
PhysicalOrder、PhysicalHashAggregate、物化 CTE):即第 3 节的路径②。子分组的 sink 是该算子,职责是把它填满;填满后它成为父组那条链的 source,向上供数。 - JOIN build 侧:子分组的 sink 是 join 算子(标记
JOIN_BUILD),职责是建哈希表;建完后父组的 probe 链才能开跑(第 6 节)。 - 结果收集器:子分组的 sink 是收集器,职责是把查询结果灌满它;灌满后收集器成为顶层 pipeline 的 source,把结果交回客户端(第 1 节的入口代码正是这种情况)。
子分组必须是一个完整的 MetaPipeline 而不是一条 Pipeline,因为新 sink 下面的子树可能还含有别的阻塞算子,会再切出多条 pipeline、再生出更深一层子分组——递归结构的每一层都是”一组共享 sink 的 pipeline + 若干子分组”。而”子组完全跑完、父组才能开始”这条规则,正是在 CreateChildMetaPipeline 里登记的(第 5 节)。
Executor 取用时按的正是这两个维度:
// src/parallel/executor.cpp:404-416(节选)
root_pipeline->GetPipelines(root_pipelines, false);      // 只取根组内的 pipeline
...
root_pipeline->GetMetaPipelines(to_schedule, true, true); // 递归取所有 MetaPipeline
// PipelineCompleteEvent 的个数等于 MetaPipeline 的个数
total_pipelines = to_schedule.size();
最后一行的信息量最大:PipelineCompleteEvent 是按 MetaPipeline 一个一个建的,不是按 Pipeline。因为”一组共享 sink 的链全部完成”才构成一个有意义的里程碑——sink 的 Finalize 正是挂在这个里程碑上。
—## 5. 组间依赖的登记:CreateChildMetaPipeline
第 3 节的路径②里,识别出阻塞算子之后调用的就是 CreateChildMetaPipeline。它在切出新分组的同时,把”子组先跑完、父组再开始”的组间顺序登记下来:
// src/parallel/meta_pipeline.cpp:100-110
MetaPipeline &MetaPipeline::CreateChildMetaPipeline(Pipeline ¤t, PhysicalOperator &op, MetaPipelineType type) {
children.push_back(make_shared_ptr<MetaPipeline>(executor, state, &op, type));
auto &child_meta_pipeline = *children.back().get();
// 记下父 pipeline
child_meta_pipeline.parent = ¤t;
// 子 MetaPipeline 必须完全结束,本 MetaPipeline 才能开始
current.AddDependency(child_meta_pipeline.GetBasePipeline());
// 子 MetaPipeline 同样属于当前的递归 CTE
child_meta_pipeline.recursive_cte = recursive_cte;
return child_meta_pipeline;
}
注释已写明:子 MetaPipeline 必须完全结束,父 pipeline 才能开始。登记是双向的:
// src/parallel/pipeline.cpp:248-252
void Pipeline::AddDependency(shared_ptr<Pipeline> &pipeline) {
    D_ASSERT(pipeline);
    dependencies.push_back(weak_ptr<Pipeline>(pipeline));
    pipeline->parents.push_back(weak_ptr<Pipeline>(shared_from_this()));
}
依赖关系是在递归下降构建 pipeline 的同时建立的,不是事后分析出来的。这带来一个结构性结果:依赖图跟随算子树的递归结构生成,边只从父指向子、子不回指父,因此天然无环。Executor::VerifyScheduledEvents 里的 DFS 验环整个函数体都包在 #ifdef DEBUG 中(executor.cpp:274-288)——它只在开发期用来验证”依赖图无环”这一不变量,发布版不编译这段代码,运行时的调度也不依赖它。
“阻塞侧先于流式侧完成”这条约束,同样是由 current.AddDependency(...) 这一行登记出来的。plan-driven 模型里 build 与 probe 各占一个静态线程组、互相等对方让出线程而形成的那类死锁,在这里被结构性地排除了:build 与 probe 不是同时占着线程的两组执行流,而是依赖图上有序的两个阶段——probe 链的任务要等 build 子组的 CompleteEvent 触发之后才会被调度,不存在互相等待的窗口。
6 Hash Join:build 侧为什么要单独成一个子树
一般算子只有一个 child,join 有两个,所以它必须override BuildPipelines。这段代码处理”build 先于 probe”:
// src/execution/operator/join/physical_join.cpp:31-66(节选)
void PhysicalJoin::BuildJoinPipelines(Pipeline ¤t, MetaPipeline &meta_pipeline, PhysicalOperator &op,
bool build_rhs) {
op.op_state.reset();
op.sink_state.reset();
// current 就是 probe pipeline:把本算子挂进去
auto &state = meta_pipeline.GetState();
state.AddPipelineOperator(current, op); // ①
// 记住最后一条 pipeline,之后建 child pipeline 时要用它来接依赖
vector<shared_ptr<Pipeline>> pipelines_so_far;
meta_pipeline.GetPipelines(pipelines_so_far, false);
auto &last_pipeline = *pipelines_so_far.back();
vector<shared_ptr<Pipeline>> dependencies;
optional_ptr<MetaPipeline> last_child_ptr;
if (build_rhs) {
// 右侧(build 侧):以本算子为 sink 建一个子 MetaPipeline
auto &child_meta_pipeline = meta_pipeline.CreateChildMetaPipeline(current, op, MetaPipelineType::JOIN_BUILD);
child_meta_pipeline.Build(op.children[1]); // ②
if (op.children[1].get().CanSaturateThreads(current.GetClientContext())) {
// 若 build 侧本身就能吃满所有线程,就不只让 LHS 本条 pipeline 依赖 RHS,
// 而是递归地让 LHS 的所有子孙也依赖它——以此避开广度优先的计划求值
child_meta_pipeline.GetPipelines(dependencies, false); // ③
last_child_ptr = meta_pipeline.GetLastChild();
}
}
// 继续在 LHS(probe 侧)上展开当前 pipeline
op.children[0].get().BuildPipelines(current, meta_pipeline); // ④
if (last_child_ptr) {
// 上面设过指针,说明要把那组递归依赖真正接上
meta_pipeline.AddRecursiveDependencies(dependencies, *last_child_ptr);
}
...
}
四个动作,四个设计点。
① join 算子在 probe pipeline 里只是个中间算子。 probe 是流式的:左表数据流过来,查一下哈希表,带上匹配结果继续往下走。所以 join 不切断 probe 侧的 pipeline。
② build 侧另起一个 JOIN_BUILD 类型的子 MetaPipeline。 类型标记不是装饰,它决定了后续的同步策略:
// src/include/duckdb/parallel/meta_pipeline.hpp:16-19
enum class MetaPipelineType : uint8_t {
    REGULAR = 0,   //! 共享的 sink 是普通 sink
    JOIN_BUILD = 1 //! 共享的 sink 是一个 join build
};
调度阶段会依据这个标记,给同一父节点下的 JOIN_BUILD 兄弟组之间拉两段额外的栅栏。源码注释把顺序写得很明确:
// src/parallel/executor.cpp:220-225
// 下面这组依赖让事情按这个顺序发生:
// 1. 所有 join build 子 pipeline 跑到 Combine
// 2. 所有 join build 子 pipeline 做 PrepareFinalize
// 3. 所有 join build 子 pipeline 做 Finalize
// 算子在 PrepareFinalize 里通过 TemporaryMemoryManager(TMM)申报自己的内存用量;
// 等到子 pipeline 做 Finalize 时,所需内存已全部已知,TMM 就能做出有依据的分配判断
理由在后两行。TMM 指 TemporaryMemoryManager(src/include/duckdb/storage/temporary_memory_manager.hpp),DuckDB 临时内存的全局协调器:hash join、hash aggregate、sort 这类内存大户先向它申报需求,它再根据整体内存预算和所有申报方的竞争情况分别批一个内存配额,配额决定算子走不走 external 落盘路径、切多少个分区。回到这里的场景:hash join 在 PrepareFinalize 里向 TMM 申报内存需求,只有等所有 build 都报完,TMM 才知道总量、才能决定各自能用多少,进而定下 radix 分区位数。所以 Finalize 必须整体晚于 PrepareFinalize,而 PrepareFinalize 又必须整体晚于 Combine——两道栅栏,正是这个信息依赖的直接产物。
③ CanSaturateThreads 决定依赖的传播范围。 如果 build 侧规模足够大、自己就能吃满所有线程,那就不只让 probe pipeline 依赖它,而是递归地让 probe 侧的所有子孙 pipeline 都依赖它。源码注释给出的理由是避开广度优先的计划求值(this prevents breadth-first plan evaluation)——不让所有分支的 build 同时启动,那样会让多个大哈希表同时驻留内存。
判断依据是估算线程数与实际线程数的比较:
// src/execution/physical_operator.cpp:75-83
bool PhysicalOperator::CanSaturateThreads(ClientContext &context) const {
#ifdef DEBUG
    // debug 构建恒返回 true,以保证依赖它的那段代码充分受测
    return true;
#else
    const auto num_threads = NumericCast<idx_t>(TaskScheduler::GetScheduler(context).NumberOfThreads());
    return EstimatedThreadCount() >= num_threads;
#endif
}
这是一次以并发度换内存峰值的取舍:少一点重叠执行,换更可控的内存占用。DEBUG 构建直接返回 true,让这条较少触发的路径在测试中始终被覆盖。
④ 先 build 再 probe 的展开顺序。 代码顺序即语义顺序:先 child_meta_pipeline.Build(op.children[1])(RHS),后 op.children[0].get().BuildPipelines(...)(LHS)。这与类注释的规则 1 对应:
// src/include/duckdb/parallel/meta_pipeline.hpp:23-31(节选)
//! 构建时遵循以下规则:
//! 1. 对 join,先把阻塞侧建完,再下到 probe 侧
//! 2. child pipeline 最后建(例如 hash join 在 probe 结束后会成为 source:为 FULL OUTER JOIN 扫哈希表)
6.1 规则 2:child pipeline 与 FULL OUTER JOIN
规则 2 说的是第三种情况:某些 join 在 probe 结束后自己还要再当一次 source。FULL OUTER JOIN 需要在 probe 完成后扫一遍哈希表,把从未被匹配到的 build 侧行补输出来。
// src/execution/operator/join/physical_join.cpp:79-82
// join 在 RIGHT/OUTER 时会成为 source;hash join 转为 out-of-core 时也会
if (op.Cast<PhysicalJoin>().IsSource()) {
    meta_pipeline.CreateChildPipeline(current, op, last_pipeline);
}
注释里的第二个条件同样重要:hash join 变成 out-of-core(内存不够、溢出到磁盘)时也会成为 source,因为溢写的数据需要在之后被重新读回来处理。external hash join 走的就是这条路径。
child pipeline 的依赖建立方式与前面不同——它必须等 current 以及”在 current 之后创建的所有 pipeline”都完成:
// src/parallel/meta_pipeline.cpp:238-252(节选)
void MetaPipeline::CreateChildPipeline(Pipeline ¤t, PhysicalOperator &op, Pipeline &last_pipeline) {
// 规则 2:current 必须已经完整建好(一直建到 source),才能创建 child pipeline
D_ASSERT(current.source);
...
// child pipeline 依赖于(本 MetaPipeline 内)从 current 到现在之间
// 所有被加进来的 pipeline,包括 current 本身
pipeline_dependencies[child_pipeline].push_back(current);
AddDependenciesFrom(child_pipeline, last_pipeline, false);
}
原因很直白:扫哈希表补输出未匹配行这件事,必须等所有 probe 分支都探测完,否则无法确定哪些行没被匹配到。
7 完整示例:一条两表 join 的拆分过程
SELECT a.x, SUM(b.y)
FROM a JOIN b ON a.k = b.k
WHERE a.x > 10
GROUP BY a.x;
物理计划(简化):
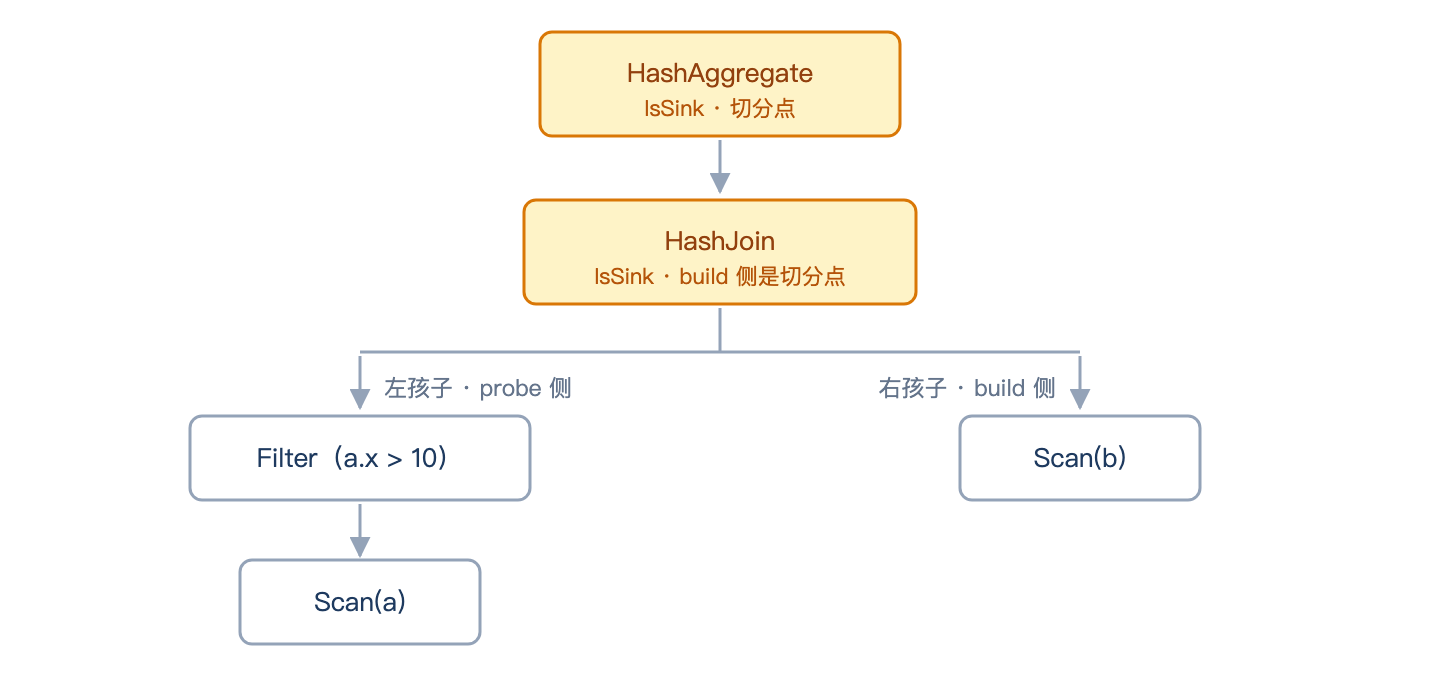
图 7 示例查询的物理计划树:两个 IsSink 算子就是两个切分点
Build 的递归轨迹:
MetaPipeline#0 (sink = nullptr → 结果收集器)
  └─ Build(HashAggregate)
       ├─ IsSink → 路径②
       ├─ HashAggregate 成为 P0 的 source
       └─ CreateChildMetaPipeline → MetaPipeline#1 (sink = HashAggregate)
            └─ Build(HashJoin)
                 ├─ 覆写:BuildJoinPipelines
                 ├─ HashJoin 加入 P1 的 operators(作为 probe)
                 ├─ build_rhs → CreateChildMetaPipeline(JOIN_BUILD) → MetaPipeline#2 (sink = HashJoin)
                 │    └─ Build(Scan(b)) → 路径① → Scan(b) 成为 P2 的 source
                 └─ 继续 LHS:Filter → 路径③ 加入 operators
                      └─ Scan(a) → 路径① → 成为 P1 的 source
Ready() 翻转 operators 之后,最终产物:
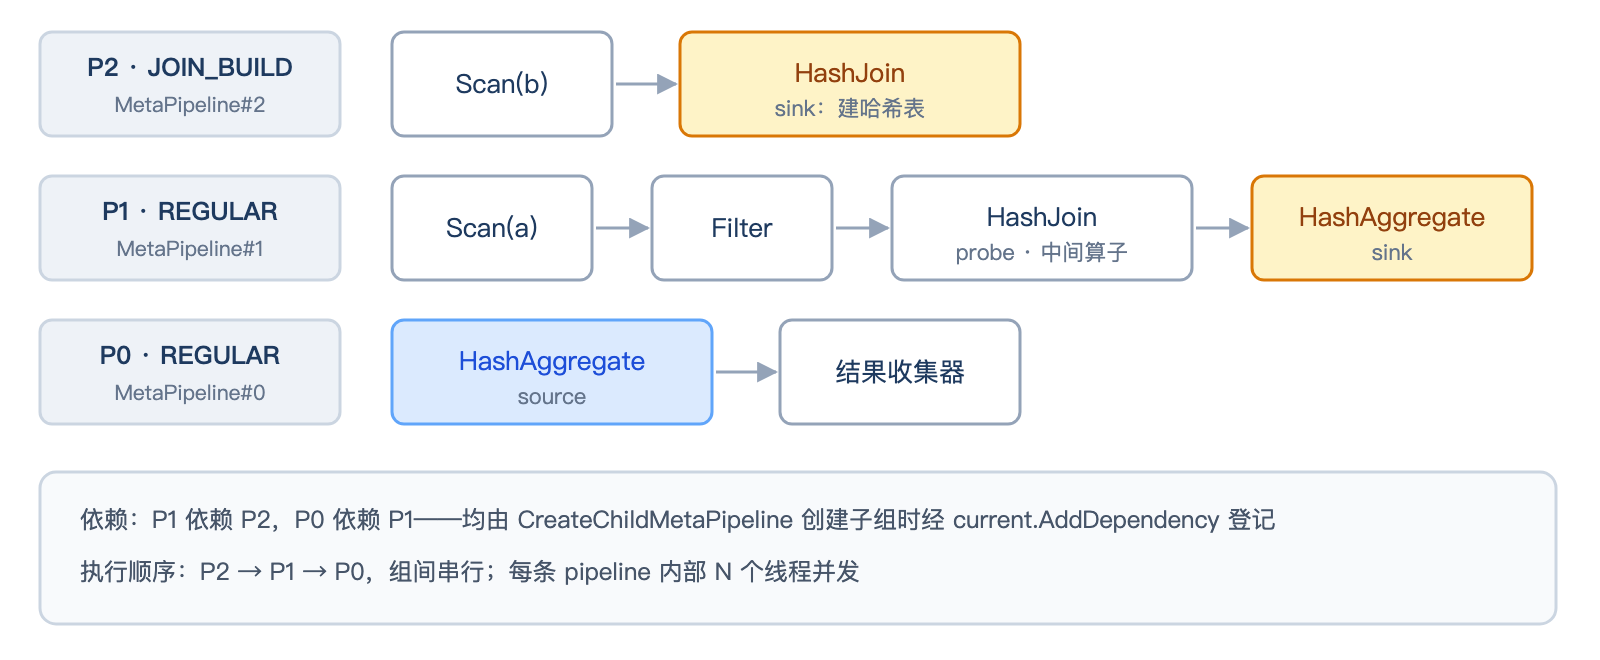
图 8 Ready() 之后的最终产物:三条 pipeline 与两条依赖边
三条 pipeline,两个阻塞点,两条依赖边——树被拍成了链,顺序被记进了 dependencies。
这份产物里没有并行度。P2 要开几个线程扫 b,计划里没有写,那是运行期 MaxThreads() 的事。
8 切分结果在哪里可以被观察到
切分本身不对外暴露,但它的形状会以三种方式显现在可观测的输出里。
EXPLAIN 给出物理计划树。阻塞算子的位置就是未来的切分点:HASH_JOIN、HASH_GROUP_BY、ORDER_BY 出现在哪里,树就会在哪里被切开。
EXPLAIN SELECT a.x, SUM(b.y) FROM a JOIN b ON a.k = b.k WHERE a.x > 10 GROUP BY a.x;
EXPLAIN ANALYZE 给出每个算子的实际行数与耗时,切分边界会体现为耗时的分布形态:同一条 pipeline 内的算子耗时相互重叠,因为它们在流水线上并发执行;跨 pipeline 的耗时则是分段的,因为依赖边强制了串行。
改变 threads 会让这种差别更明显。阻塞点两侧的串行关系不随线程数变化而消失,所以某一段耗时如果随线程数增加几乎不变,它通常落在一个无法并行的 sink 上——比如不实现 ParallelSink() 的算子。
SET threads = 1;   -- 单线程基线
SET threads = 8;   -- 观察哪些阶段真的缩短了
需要结构化数据时,profiling 输出可以直接读:
PRAGMA enable_profiling = 'json';
PRAGMA profiling_output = '/tmp/profile.json';
源码里另外留了两个调试出口:Pipeline::Print() 与 Pipeline::PrintDependencies()(src/parallel/pipeline.cpp:259-267),在 debug 构建里下断点调用,可以直接打出某条 pipeline 的算子链和它的依赖链。
9 小结
物理计划树被切成 pipeline 这道工序,没有代价模型,也没有搜索空间:入口是 MetaPipeline::Build 在算子树上的一次自顶向下递归,每个算子在 BuildPipelines 里通过三条路径决定自己的归属——叶子且非 sink 的算子成为当前链的 source(路径①),IsSink() 为真的算子就地切断、另开子分组(路径②),流式算子直接追加进当前链的 operators(路径③)。切分判据只有 IsSink() 这一个布尔值:切点处上下两条链共享同一个算子,下面那条把它当 sink 写入,上面那条把它当 source 读出。
MetaPipeline 是共享同一 sink 的一组 pipeline,它存在的理由是 sink 的生命周期需要被整体管理——Finalize 要等组内所有链都跑完,PipelineCompleteEvent 因此按 MetaPipeline 计数而不是按 Pipeline。JOIN_BUILD 这个类型标记则把 hash join 的内存协商需求带进了调度层:Combine、PrepareFinalize、Finalize 三个阶段之间的两道栅栏,来自 TemporaryMemoryManager 需要先收齐所有 build 的内存申报。
依赖的生成方式是理解这套机制的关键。依赖不是独立的分析阶段,而是切分递归的副产品:CreateChildMetaPipeline 在创建子分组时同步调用 Pipeline::AddDependency,把父组的 dependencies 与子组的 parents 双向登记。依赖边的方向恒为递归在后的父组指向递归在前的子组、子不回指父,依赖图因此结构无环,VerifyScheduledEvents 的 DFS 验环也才敢只在 DEBUG 构建里编译。同理,plan-driven 模型里 build 与 probe 各占静态线程组、互相等待的死锁在这里不成立:probe 链的任务要等 build 子组的 CompleteEvent 触发后才会被调度,在那之前根本不占用线程。
这道工序的输出止步于拓扑结构:一组 source/operators/sink 三段式角色齐备的 Pipeline 对象,加上组间 dependencies 与组内 pipeline_dependencies 两套先后约束。并行度的问题被刻意留白——每条链创建多少个任务由调度器按 MaxThreads() 决定;数据分片与任务并不一一对应,source 的 ParallelScanState 在运行期动态发放 morsel,线程空闲了就领一块。